
 gekennzeichnet.
Kategorien: Künstliche Intelligenz und Security
Am 21. Oktober 2026 lieferte die Release-Pipeline von LiteLLM Schadcode aus: Version 1.107.0 stahl Zugangsdaten und war darauf ausgelegt, weiteren Code nachzuladen. Beschrieben wird, wer betroffen sein kann, wie sich ein Befall prüfen und bereinigen lässt, ohne den Schadcode erneut zu starten, und was Betreiber von KI-Gateways dauerhaft ändern sollten.
Ein KI-Gateway steht zwischen Anwendungen und Modellanbietern. Es bündelt Schlüssel, leitet Anfragen weiter und protokolliert oft Prompts und Antworten. Gerät ein solcher Baustein unter fremde Kontrolle, ist der Schaden größer als bei einer gewöhnlichen Bibliothek. Der LiteLLM Supply-Chain-Angriff vom 21. Oktober 2026 zeigt das: In wenigen Stunden gelangte Schadcode auf Server, Container und Entwicklerrechner. Wer LiteLLM kompromittiert vorfindet oder dies vermutet, braucht eine klare Reihenfolge statt Aktionismus.
Stand der Quellen: 22.10.2026. Das Projekt hat weitere Updates angekündigt, einzelne Angaben können sich daher ändern.
Zur Abgrenzung: Im März 2026 gab es bereits einen früheren Vorfall mit anderen Versionen (1.82.7 und 1.82.8). Hier geht es ausschließlich um den Oktober-Vorfall und die Version 1.107.0. Die Angaben stützen sich auf die Vorfallsseite von LiteLLM und die technischen Analysen von Wiz und JFrog.
Was am 21. Oktober 2026 passiert ist
Laut LiteLLM wurde die Release-Pipeline des Projekts kompromittiert. Dabei entstand eine Version 1.107.0, die nicht dem veröffentlichten Quelltext entsprach. Sie landete auf drei Wegen bei Nutzern:
- als Paket
litellmauf PyPI, dem zentralen Paketverzeichnis für Python, - als Container-Image auf Docker Hub,
- als Container-Image in der GitHub Container Registry (GHCR).
Bei den Images waren die Tags v1.107.0, latest, main-latest und main-stable betroffen. Besonders tückisch: Der offizielle Quelltext-Tag v1.107.0 auf GitHub enthält laut Projekt keine Schaddateien. Die Artefakte stammten aus einem vom Angreifer kontrollierten Doppelgänger-Repository. Wer den Quelltext prüft, sieht also nichts Auffälliges. Enterprise-Kunden, die die private Registry des Projekts nutzen, waren laut LiteLLM nicht betroffen.
Alle Zeiten stammen aus der Vorfallsseite und gelten für den 21. Oktober 2026 in UTC. Zur Umrechnung: In Deutschland gilt noch die Sommerzeit (UTC plus zwei Stunden), 11:39 UTC entspricht also 13:39 Uhr.
| Kanal | Betroffen | Zeitfenster (UTC) |
|---|---|---|
| PyPI | litellm 1.107.0 (sieben Wheels, so heißen vorgebaute Pakete) | 11:39 bis 13:23 |
| Docker Hub | Tags v1.107.0, latest, main-latest, main-stable | 11:46 bis 14:20 |
| GHCR | gleiche Tags, unter anderem litellm, litellm-database, litellm-non_root | ab 11:46, spätestens bis 13:51 |
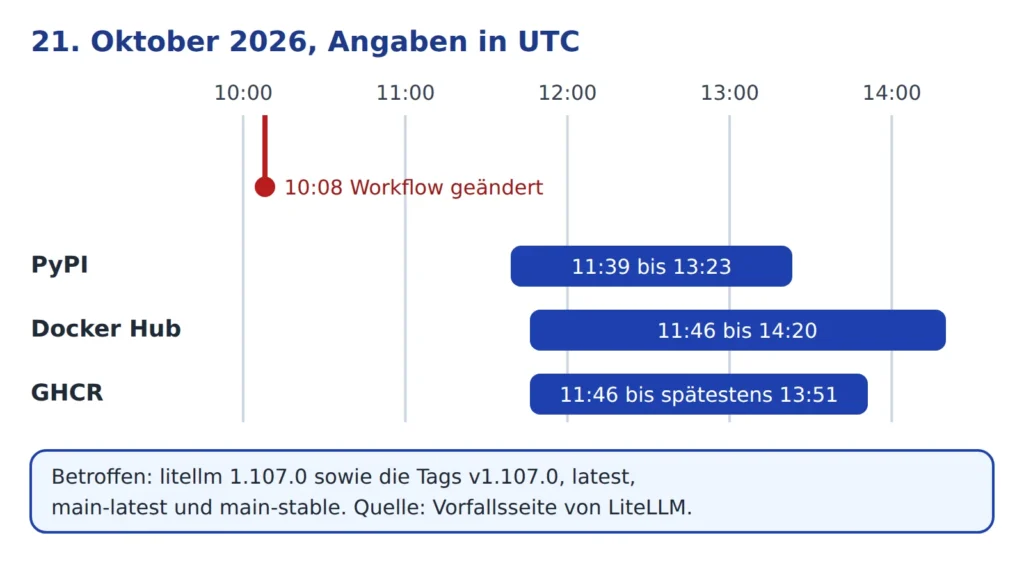
Die Zeitleiste der Vorfallsseite beginnt früher. Um 10:08 UTC wurde eine Änderung am Release-Workflow vorgenommen, um 11:08 lief die Produktions-Pipeline an, und gegen 11:40 erschienen die sieben Wheels auf PyPI. Um 13:23 UTC entfernte PyPI die Version. Die GHCR-Tags waren um 13:51 UTC nicht mehr verfügbar, die Docker-Hub-Tags zeigten noch länger auf das kompromittierte Image. Erst um 14:20 UTC waren alle betroffenen Tags entfernt oder auf geprüfte Artefakte umgestellt. Die Vorfallsseite nennt in ihrer Übersicht außerdem eine abweichende Uhrzeit für den Beginn. Diese Abweichung wird hier nicht aufgelöst, die Beitragsangaben folgen der UTC-Zeitleiste.
Als Meldestelle im Repository dient das Issue 47826. Details aus dem Issue werden hier nicht verwendet.
Wer vom LiteLLM Supply-Chain-Angriff betroffen sein kann
Ein Supply-Chain-Angriff, auf Deutsch Lieferkettenangriff, trifft nicht das Ziel selbst, sondern einen Baustein, dem das Ziel vertraut. Hier war es ein Softwarepaket, das automatisch bezogen wird. Betroffen sein können daher alle, die im genannten Zeitfenster Artefakte aus den drei Kanälen bezogen oder gestartet haben:
- Installationen mit
pip install litellmohne feste Version, die im Zeitfenster liefen und 1.107.0 zogen. - Installationen, die ausdrücklich auf
litellm==1.107.0festgelegt waren. Auch das feste Pinning, also das Festlegen einer genauen Version, schützte hier nicht. - Docker-Starts oder Neubauten von Images mit den genannten Tags im Zeitfenster, auch in CI-Pipelines und auf Entwicklerrechnern.
- Images, die intern auf Basis eines dieser Tags gebaut und anschließend weiterverwendet wurden.
Nicht betroffen sind laut Projekt Versionen bis einschließlich 1.106.2. Als Rückfallstand empfiehlt LiteLLM, auf 1.106.2 oder eine ausdrücklich vor dem Vorfall veröffentlichte Version festzulegen.
Ein weiterer Punkt ist die Frage der Abhängigkeiten. Viele Werkzeuge ziehen LiteLLM als Unterpaket nach. Beim früheren Vorfall im März wurde das laut LiteLLM belegt. Für den Oktober liegt es nahe, ist aber nicht einzeln bestätigt. Deshalb lohnt sich ein Blick in Lockfiles und Abhängigkeitsbäume, nicht nur in die direkt installierten Pakete.
Ein Unterschied zum März-Vorfall ist wichtig. Damals galt laut der Meldung zum März-Vorfall das offizielle Proxy-Image als nicht betroffen. Diesmal waren Images betroffen. Wer sich auf die frühere Einschätzung verlässt, könnte den Container-Betrieb zu Unrecht für sicher halten.
Die Reichweite lässt sich nicht verlässlich beziffern. Wiz nennt rund 49.000 Downloads laut einer Statistik-Webseite, doch wie viele davon tatsächlich zum Einsatz kamen, ist offen. Entscheidend ist ohnehin der eigene Bestand: Ein einziger betroffener Host mit Zugriff auf Cloud-Rollen genügt für den Ernstfall.
Was der Schadcode tut: Start bei jedem Python-Aufruf
Laut JFrog legt das Paket drei Dateien im Verzeichnis site-packages ab, in das Python seine Pakete installiert: cook.pth, cook.py und sitecustomize.py. Der Mechanismus ist unscheinbar und wirksam.
- Eine
.pth-Datei ist eigentlich dafür gedacht, Suchpfade für Python zu ergänzen. Zeilen, die mitimportbeginnen, werden aber beim Start des Interpreters ausgeführt. Die Dateicook.pthimportiert socook.py. sitecustomize.pyist ein Hook, den Python beim Start automatisch lädt, sofern die Datei existiert. Nicht jede solche Datei ist bösartig, sie kommt gelegentlich legitim vor. Unerwartete Fundstellen sind aber zu prüfen.
Die Folge: Der Code läuft bei jedem Start von Python, auch wenn die Anwendung litellm nie importiert. Auch ein Aufruf von pip startet Python und kann den Schadcode auslösen. Genau deshalb stützen sich die Prüfschritte weiter unten zuerst auf das Dateisystem.
Gesammelt wird laut JFrog und Wiz sehr viel. Dazu zählen Zugangsdaten für Cloud-Dienste (AWS, Azure, Google Cloud), Kubernetes- und Docker-Konfigurationen, SSH- und GPG-Schlüssel, Zugangsdaten für Git, npm und PyPI, Umgebungsvariablen und .env-Dateien, Browserdaten sowie Zugangsdaten von KI-Werkzeugen. Auf Systemen mit einer LiteLLM-Proxy-Datenbank liest der Code laut beiden Analysen die dort gespeicherten Schlüssel der Modellanbieter aus.
Die Daten werden verschlüsselt und per POST an eine nachgebaute Domain gesendet, die dem Original ähnelt. Sie wird hier als litellm[.]dev entschärft geschrieben und sollte im Netz gesperrt werden. Ohne den privaten Schlüssel des Angreifers lässt sich mitgeschnittener Verkehr nicht entschlüsseln. Das hilft den Betroffenen aber nicht, denn die Daten sind abgeflossen, sobald sie den Host verlassen haben.
Der Nachlade-Loader
Zusätzlich enthält sitecustomize.py laut JFrog einen Loader. Er startet auf Linux und macOS einen losgelösten Hintergrundprozess, der eine Lock-Datei unter /tmp/remote_code_loader.lock hält. Der Prozess ist darauf ausgelegt, stündlich eine Adresse aus einer öffentlichen GitHub-Datei zu lesen, den sogenannten Dead Drop. Das ist ein toter Briefkasten: Der Angreifer kann dort jederzeit eine Adresse hinterlegen, ohne selbst direkt aufzutreten. Dann würde der Loader weiteren Code von dort holen und ausführen.
Zum Analysezeitpunkt war diese Datei nach JFrog leer, laut Wiz nur mit Testwerten belegt. Das Repository wurde von GitHub gegen 13:30 UTC entfernt. Ein Nachladen wurde nicht beobachtet. Ob es dazwischen Nachladungen gab, ist nicht belegt. Der Loader bleibt dennoch ein möglicher Fernzugriffsweg und gehört zur Bereinigung. Auf Windows scheitert der Hintergrundteil laut JFrog, weil er auf eine Funktion angewiesen ist, die dort fehlt. Der Stealer in cook.py läuft aber auch dort.
Wie der Angriff möglich wurde: Tokens in Logs
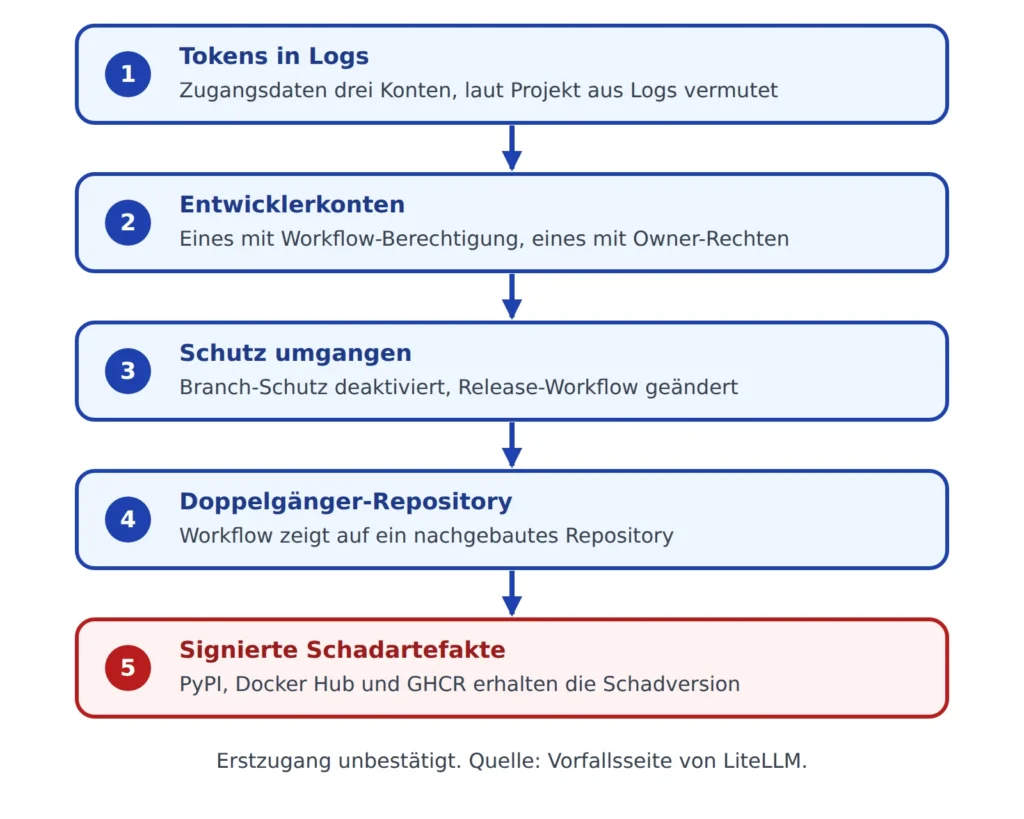
Der Kern der Lehre liegt nicht im Schadcode, sondern im Weg, auf dem er in die Release-Pipeline gelangte. Wiedergegeben wird hier die Darstellung von LiteLLM, ergänzt um den Hinweis, dass der Erstzugang unbestätigt ist.
Der Angreifer verfügte laut Projekt über GitHub-CLI-Zugangsdaten von drei Entwicklerkonten. Eine davon hatte Berechtigungen für Workflows, ein weiteres Token gehörte einem Organisations-Owner. Damit wurden Branch-Schutzregeln deaktiviert und der Release-Workflow so geändert, dass er ein Doppelgänger-Repository nutzte. Die dort gebauten Artefakte wurden anschließend signiert und veröffentlicht. Außerdem wurden laut Projekt Workflow-Protokolle gelöscht, was die Analyse erschwert. Am Montag davor waren Release-Rechte für zwei interne Ingenieure vorübergehend erweitert worden.
Woher stammten die Tokens? Das Projekt vermutet: aus Logs einer öffentlich erreichbaren internen LiteLLM-Instanz. Laut LiteLLM kann Claude Code das OAuth-Token der GitHub-CLI in einen Antworttext einbetten. Wird der Antwortkörper protokolliert, landet das Token im Log. Das ist eine Aussage des Projekts mit den Worten „kann“ und „vermutet“. Sie ist kein belegter Fehler eines Herstellers und wird hier nicht als solcher dargestellt. Als Ausgangspunkt nennt die Vorfallsseite ein unbekanntes, unauffällig benanntes Konto auf dieser Instanz. Möglicherweise führte eine kürzlich geschlossene Sicherheitslücke dorthin, bestätigt ist das nicht.
Ein KI-Gateway sieht, was Anwendungen und Agenten anfragen und antworten. Landet das im Log, wird das Log zum Schlüsselbund.
Diese Beobachtung gilt weit über LiteLLM hinaus. Wer KI-Agenten oder Coding-Werkzeuge mit weitreichendem Zugriff einsetzt, sollte wissen, welche Geheimnisse in Eingaben und Antworten auftauchen können. Zur Kontrolle solcher Agenten gibt es einen Beitrag über KI-Agentensysteme und Datenschutz. Auch die den Risiken von Entwicklerwerkzeugen mit viel Handlungsspielraum über Agentic Coding sind zu nennen.
Bemerkenswert ist auch die Rolle der Signatur. Die veröffentlichten Artefakte waren signiert. Das beweist nur, dass der Workflow lief, nicht, dass der Code der erwartete war. Eine Signatur ist so vertrauenswürdig wie die Pipeline, die sie erzeugt. Die Vorfallsseite betont zudem, dass der Angreifer mehrere voneinander unabhängige Schutzmaßnahmen überwinden musste.
Schritt 1: Betroffenheit prüfen, ohne Python zu starten
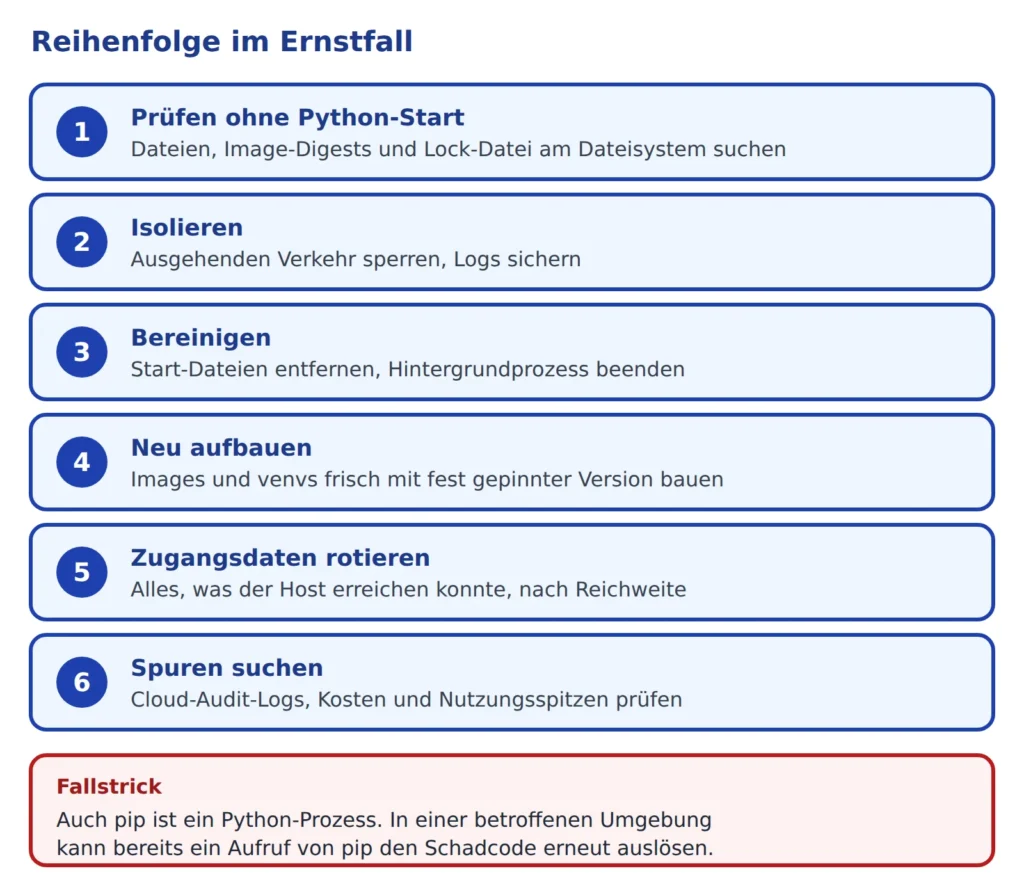
Die Vorfallsseite nennt pip show litellm als Prüfung auf die installierte Version. Dieselbe Seite warnt davor, mit pip install zu beginnen, weil jeder Python-Start die Schaddateien erneut ausführt. Daraus ergibt sich eine Schlussfolgerung, die nicht ausdrücklich in der Quelle steht: In einer möglicherweise befallenen Umgebung sollte zuerst das Dateisystem geprüft werden. Auch pip show ist ein Python-Prozess. Es eignet sich in einer sauberen Umgebung, etwa in einem frisch gestarteten Container ohne Befall, nicht aber als erster Schritt auf dem verdächtigen Host.
Eine sinnvolle Reihenfolge für die Prüfung:
- Bestand erfassen: Hosts, Container, CI-Runner, Entwicklerrechner und Images, auf denen LiteLLM laufen oder gebaut worden sein könnte.
- Image-Digests und Tags in Registries und Deployments ansehen. Ein Digest ist der Hashwert eines Images und identifiziert es unveränderlich, im Gegensatz zu einem Tag wie
latest. LiteLLM nennt für den Docker-Hub-Image-Index einen Digest, der mitsha256:1bbcb1443bc9beginnt. Der vollständige Wert steht auf der Vorfallsseite. Für die anderen GHCR-Images waren die Werte dort gekürzt. - Das Dateisystem durchsuchen, ohne Python zu starten.
- Laufende Prozesse und die Lock-Datei prüfen.
Für Schritt 3 und 4 reichen Standardwerkzeuge von Linux:
find / -xdev \( -name 'cook.pth' -o -name 'cook.py' -o -name 'litellm-1.107.0.dist-info' \) 2>/dev/null
find / -xdev -name 'sitecustomize.py' 2>/dev/null
ls -l /tmp/remote_code_loader.lock
fuser -v /tmp/remote_code_loader.lock
docker images --digests | grep -i litellm
Zu den Indikatoren zählen laut Vorfallsseite die Verzeichnisse litellm-1.107.0.dist-info, die Dateien cook.pth, cook.py und sitecustomize.py in site-packages sowie passende kompilierte Dateien im Ordner __pycache__. Wer gezielt nach LiteLLM cook.pth sucht, findet in den Analysen von Wiz und JFrog zusätzlich Hashwerte der Dateien. Diese werden hier nicht abgedruckt.
Dabei gilt: Ein leerer Befund beweist nichts. Container können kurzlebig sein, Aufräumjobs leeren /tmp, und Spuren lassen sich entfernen. Laut Vorfallsseite bestätigt der Fund einer Marker-Datei die Exfiltration, ihr Fehlen beweist aber keine Sauberkeit. Wer im Zeitfenster installiert oder gestartet hat, sollte deshalb von einem Befall ausgehen, auch wenn die Suche nichts findet.
Schritt 2 bis 4: Isolieren, bereinigen, neu aufbauen
Beim Isolieren (Schritt 2) geht es darum, den Schaden zu begrenzen. Betroffene Systeme werden vom Netz getrennt oder zumindest am ausgehenden Verkehr (Egress) gehindert. Die Domain litellm[.]dev wird blockiert. Vor jeder Änderung sind Logs zu sichern: Proxy-Logs, DNS-Logs und Audit-Protokolle der Cloud. Sie werden später für die Spurensuche gebraucht.
Für die Bereinigung (Schritt 3) nennt die Vorfallsseite diese Maßnahmen: cook.pth, cook.py und sitecustomize.py samt zugehöriger Dateien in __pycache__ werden aus jedem betroffenen site-packages-Verzeichnis entfernt. Der losgelöste Python-Prozess, der die Lock-Datei hält, wird beendet. JFrog ergänzt, dass auch die Marker-Dateien unter /tmp und Prozesse mit Arbeitsverzeichnis / zu prüfen sind. Das Löschen geschieht mit Werkzeugen, die Python nicht starten.
Anschließend wird auf litellm==1.106.2 oder eine ausdrücklich vor dem Vorfall veröffentlichte Version zurückgegangen. LiteLLM und JFrog empfehlen aber, Images und virtuelle Umgebungen nicht zu flicken, sondern neu aufzubauen. Der Grund ist einfach: Es ist schwer zu beweisen, dass wirklich jede Start-Datei und jede nachgeladene Stufe entfernt wurde. Der Neuaufbau (Schritt 4) aus verifizierten Quellen umgeht diese Unsicherheit.
Daraus folgt auch die Antwort auf eine naheliegende Frage:
Reicht es, LiteLLM einfach auf 1.106.2 zurückzusetzen?
Lief die Version 1.107.0 auf einem Host mit Internetzugang, ist laut Projekt davon auszugehen, dass Daten abgeflossen sind. Der Neuaufbau betrifft deshalb nicht nur die Anwendung, sondern auch den Host, wenn dort Zugangsdaten lagen. Auf Entwicklerrechnern gilt das ebenso wie auf Servern.
Schritt 5 und 6: Zugangsdaten rotieren und Spuren suchen
Das Rotieren der Zugangsdaten, also das Ersetzen durch neue Werte und das Sperren der alten, ist der wichtigste und zugleich mühsamste Teil. Sinnvoll ist eine Reihenfolge nach Reichweite, beginnend mit dem, was am meisten Schaden anrichten kann:
- Die IAM-Rolle der Instanz oder des Tasks. Eine IAM-Rolle ist die Identität, mit der ein Server in der Cloud handelt. Ihre Zugangsdaten stehen dem Prozess automatisch zur Verfügung, deshalb kann der Stealer sie lesen.
- Alle Schlüssel der Modellanbieter in der LiteLLM-Proxy-Datenbank sowie Master-Key und Virtual Keys, also die vom Gateway ausgegebenen Schlüssel für Anwendungen.
- Das Passwort in der
DATABASE_URL. - Alles, was in der Umgebung der Prozesse auf dem Host stand: Werte aus
.env-Dateien, Kubernetes- und Docker-Zugangsdaten, Git-, npm-, PyPI- und SSH-Schlüssel.
Erst danach lohnt die Spurensuche (Schritt 6). LiteLLM empfiehlt, in CloudTrail, dem Protokoll der AWS-Aktivitäten, nach GetCallerIdentity-Aufrufen der Instanzrolle rund um den Installationszeitpunkt zu suchen. Danach ist zu prüfen, ob die Zugangsdaten der Rolle von außerhalb der eigenen Infrastruktur verwendet wurden.
Wie schnell Missbrauch folgen kann, beschreibt Wiz. Rund viereinhalb Stunden nach dem Abfluss, zwischen 16:20 und 17:01 UTC, prüften Angreifer gestohlene AWS-Rollenzugänge mit GetCallerIdentity und fragten bei Amazon Bedrock verfügbare Modelle ab. Dieses Muster heißt LLMjacking: Fremde Zugänge zu KI-Diensten werden genutzt, damit die Rechnung beim Opfer landet. Daraus folgen konkrete Aufgaben:
- Kosten und Nutzungsspitzen bei Modellanbietern und Cloud-Konten beobachten.
- Budget- und Rate-Limits setzen, falls noch nicht vorhanden.
- In der Verwaltung des eigenen Gateways nach unbekannten Benutzerkonten suchen. LiteLLM fand ein solches Konto im eigenen Deployment.
Wichtig ist die Ordnung: Zuerst Zugang sperren, dann Spuren lesen. Wer erst Logs auswertet und währenddessen alte Schlüssel gültig lässt, gibt dem Angreifer Zeit.
Datenschutz und Meldung: Wann Art. 32 und 33 DSGVO ins Spiel kommen
Ein Vorfall dieser Art ist nicht nur ein technisches, sondern kann auch ein datenschutzrechtliches Thema sein. Das gilt, wenn auf den betroffenen Hosts personenbezogene Daten lagen oder Zugänge zu solchen Daten abgeflossen sein können. Das ist bei einem KI-Gateway schnell der Fall, weil Prompts, Antworten und Logs Namen, Kundendaten oder interne Dokumente enthalten können. Zur Protokollierung gibt es einen Beitrag über Server-Logs und IP-Adressen.
In diesem Fall verlangt Art. 32 DSGVO geeignete technische und organisatorische Maßnahmen für die Sicherheit der Verarbeitung. Kommt es zu einer Verletzung des Schutzes personenbezogener Daten, ist nach Art. 33 DSGVO zu prüfen, ob eine Meldung an die Aufsichtsbehörde erforderlich ist. Sie hat grundsätzlich innerhalb von 72 Stunden zu erfolgen, nachdem die Verletzung bekannt wurde, es sei denn, sie führt voraussichtlich nicht zu einem Risiko für die Betroffenen.
Praktisch heißt das: Früh den Datenschutzbeauftragten einbinden, den Zeitpunkt der Kenntnisnahme festhalten und dokumentieren, welche Daten auf den Hosts lagen und welche Zugänge abgeflossen sein können. Das ist ein allgemeiner Hinweis und keine Rechtsberatung. Im Einzelfall entscheiden Datenschutzbeauftragte oder Fachleute.
KI-Gateway absichern: Lehren über LiteLLM hinaus
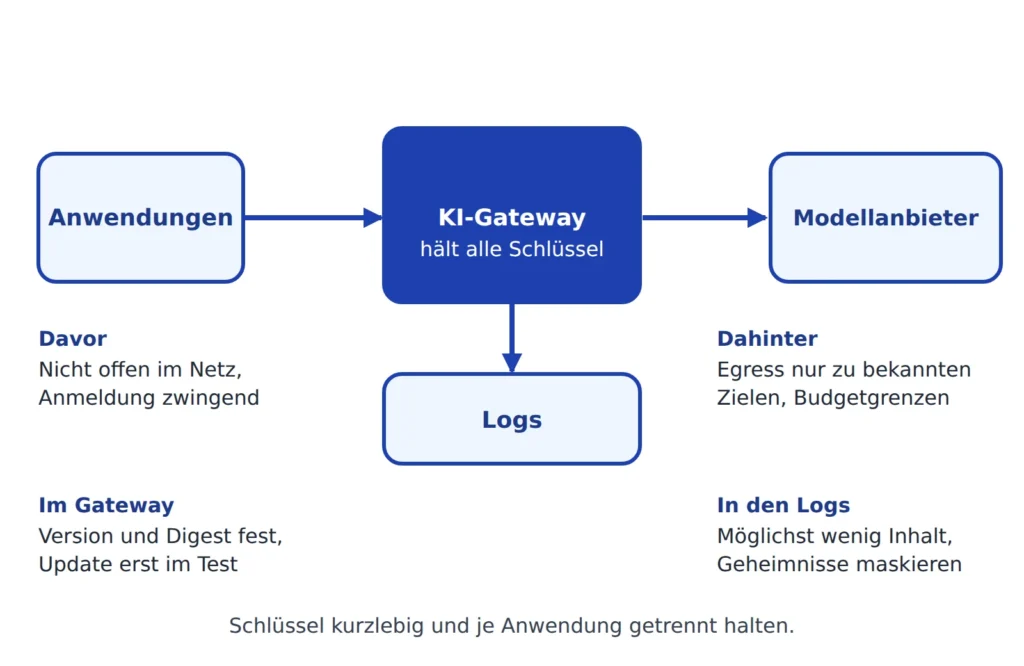
Ein KI-Gateway absichern heißt, es wie das zu behandeln, was es ist: ein Konzentrationspunkt für Schlüssel und Inhalte. Die folgenden Maßnahmen sind nicht auf LiteLLM beschränkt. Sie gelten für jedes Gateway, jeden Proxy und jede Komponente, die viele Geheimnisse berührt.
Versionen festlegen und prüfen
Kein latest in Produktion. Python-Abhängigkeiten gehören in eine Lockdatei in der Versionsverwaltung. Der Installationsmodus mit Hash-Prüfung (pip install --require-hashes) stellt sicher, dass nur Dateien mit bekanntem Hash installiert werden. Das ist in der pip-Dokumentation beschrieben. Bei Containern empfiehlt die Docker-Dokumentation, Basisimages über den Digest festzulegen (FROM image:tag@sha256:...). Der Preis: Automatische Updates entfallen. Werkzeuge wie Dependabot können Aktualisierungen als Vorschlag anbieten.
Wichtig ist die Grenze dieser Maßnahme. Hash-Pinning schützt vor nachträglichen Änderungen an einer festgelegten Version. Es schützt nicht, wenn die festgelegte Version selbst schädlich war, wie im Fall von 1.107.0. Deshalb kommt ein zweiter Schritt hinzu.
Updates erst testen, dann einführen
Neue Versionen laufen zunächst in einer Testumgebung ohne Produktivgeheimnisse. Eine Karenzzeit für frische Releases, etwa einige Tage, ist eine naheliegende Praxis. Sie ist in den Quellen nicht belegt und wird hier als Empfehlung der Redaktion genannt. Im aktuellen Fall wäre eine Version, die nur wenige Stunden online war, damit nie in Produktion gelangt.
Protokollierung klein halten
Prompts und Antworten nur dann protokollieren, wenn es einen Grund gibt. Wo es nötig ist, werden Geheimnisse maskiert, der Zugriff auf Logs eng begrenzt und die Aufbewahrung zeitlich beschränkt. Der Fall zeigt, wie ein Log zur Quelle von Tokens werden kann.
Gateway nicht offen ins Netz stellen
Interne Instanzen gehören hinter eine Anmeldung und nicht ins offene Internet. Sicherheitsupdates sind zügig einzuspielen. Ob ein Dienst von außen erreichbar ist, lässt sich mit den Web Security-Checks prüfen.
Geheimnisse kurzlebig und eng begrenzt halten
IAM-Rollen mit minimalen Rechten, getrennte Schlüssel je Anwendung, Budget- und Rate-Limits beim Anbieter. So begrenzt ein einzelner Abfluss den Schaden. Kurzlebige Zugangsdaten verlieren schneller ihren Wert.
Ausgehenden Verkehr beschränken
Der Stealer sendet an eine fremde Domain. Ein Gateway, das nur zu den eigenen Modellanbietern verbinden darf, hätte diesen Abfluss erschwert. Egress-Filter sind aufwendig, aber eine der wenigen Maßnahmen, die auch bei unbekanntem Schadcode wirken.
Release-Prozess eigener Pakete
Wer selbst Pakete oder Images veröffentlicht, sollte Branch-Schutz so einrichten, dass einzelne Konten ihn nicht aushebeln können. Freigaben werden getrennt, Berechtigungen zeitlich begrenzt. LiteLLM hatte Rechte am Montag zuvor temporär erweitert. Das zeigt, dass auch vorübergehende Ausnahmen ein Risiko bleiben.
Selbst betriebene Modelle
Wer Modelle selbst betreibt, braucht weniger fremde Schlüssel. Das ersetzt die genannten Maßnahmen nicht, verkleinert aber die Angriffsfläche. Einen Überblick bietet der Beitrag über lokale KI.
Was nach dem Vorfall offen bleibt
Mehrere Punkte sind noch nicht geklärt. Der Erstzugang ist unbestätigt, die Vorfallsseite vermutet eine kürzlich gepatchte Schwachstelle. Wie viele Systeme tatsächlich betroffen sind und welche Daten abflossen, ist offen. Für einen Zusammenhang mit dem März-Vorfall gibt es laut Socket, zitiert von The Hacker News, keinen Beleg. Auch die Zeitangaben der Quellen weichen leicht ab: Wiz nennt für PyPI die Quarantäne um 13:20 UTC, LiteLLM die Entfernung um 13:23 UTC. In diesem Beitrag gelten die Zahlen von LiteLLM.
Das Projekt hat weitere Updates und einen Prüfleitfaden angekündigt. Betreiber sollten die Vorfallsseite im Blick behalten und Angaben mit dem jeweils aktuellen Stand abgleichen. Für den 27. Oktober ist die Offenlegung einer weiteren Schwachstelle geplant, ein Bezug zum Vorfall ist nicht belegt.
Fazit: Der LiteLLM Supply-Chain-Angriff zeigt, dass ein KI-Gateway ein Konzentrationspunkt für Schlüssel und Inhalte ist. Wer 1.107.0 betrieben hat, muss nicht nur die Version ersetzen, sondern alles rotieren, was der Host sehen konnte. Und wer ein Gateway betreibt, sollte Versionen festlegen, Logs sparsam halten und den ausgehenden Verkehr begrenzen, bevor der nächste Vorfall kommt.