
 gekennzeichnet.
Kategorien: Künstliche Intelligenz
Der Europäische Datenschutzausschuss hat im Juli 2026 den Entwurf einer Leitlinie zum Auslesen von Webseiten für generative KI angenommen. Die Kernaussage: Was öffentlich sichtbar ist, ist nicht frei verwendbar. Der Beitrag ordnet die Anforderungen ein, nennt die Randnummern des Originals und erklärt, was bis zum Ende der Konsultation am 30. Oktober 2026 offen ist.
Sprachmodelle und Bildgeneratoren lernen aus riesigen Datenmengen, und ein großer Teil davon stammt aus dem offenen Netz. Web-Scraping für KI-Training ist deshalb zu einem der wichtigsten Streitpunkte im Datenschutz geworden. Mit der neuen Leitlinie legt der Europäische Datenschutzausschuss (EDSA, englisch EDPB) dar, wie die Aufsichtsbehörden die Rechtslage lesen.
Der Beitrag fasst die Leitlinie in der Reihenfolge zusammen, in der sich die Fragen in der Praxis stellen: Geltungsbereich, Rollen, Rechtsgrundlage, Sperrsignale, Datenminimierung, Transparenz und sensible Daten. Dazu kommt ein Blick auf die zweite Leitlinie zur Anonymisierung und eine Prüfübersicht. Es handelt sich um eine Einordnung und nicht um Rechtsberatung. Die Aussagen beziehen sich auf den Entwurf in Version 1.0, Änderungen sind möglich.
Web-Scraping für KI-Training: Was die EDSA-Leitlinie 03/2026 regelt und wie verbindlich sie ist
Der Titel lautet „Guidelines 03/2026 on web scraping in the context of generative AI“. Das Dokument wurde am 7. Juli 2026 als Version 1.0 zur öffentlichen Konsultation angenommen und auf der Plenartagung am 8. Juli 2026 angekündigt. Das Feedback läuft bis zum 30. Oktober 2026, 23:59 Uhr (MEZ), und wird über ein Formular auf der Konsultationsseite des EDPB eingereicht. Die Pressemitteilung des EDPB stellt die Leitlinie gemeinsam mit der Anonymisierungsleitlinie vor. Das Dokument umfasst 23 Seiten mit 77 Randnummern.
Wichtig ist der Status. Leitlinien des EDSA binden weder Gerichte noch Unternehmen. Sie geben aber die gemeinsame Auslegung der europäischen Aufsichtsbehörden wieder, und an dieser Auslegung orientieren sich Prüfungen und Bußgeldverfahren. Die Datenschutz-Grundverordnung gilt außerdem unabhängig davon. Der Entwurf schafft also keine neuen Pflichten, sondern beschreibt, wie die bestehenden Regeln beim Scraping verstanden werden.
Der Anwendungsbereich ist eng gefasst. Die Leitlinie betrifft private Stellen, das Training generativer KI und Daten aus externen Quellen, also nicht die Auswertung eigener Datenbestände (Rn. 5 und 6). Behörden und andere Modellarten, etwa klassische Prognosemodelle, sind nicht ihr Thema. Wer allgemein wissen möchte, wie sich KI-Training und Datenschutz zueinander verhalten, findet das im Beitrag KI-Training und die DSGVO.
Was als Web-Scraping gilt und wer verantwortlich ist
Die Leitlinie versteht unter Web-Scraping das automatisierte Auslesen und Speichern von öffentlich zugänglichen Quellen. Dazu zählen Register, Nachrichtenseiten, soziale Netzwerke, Foren und Blogs (Rn. 7). Das Vorgehen kann gezielt sein, etwa auf bestimmte Domains beschränkt. Es kann auch ungezielt erfolgen, als Crawling ohne enge Kriterien. Dann ist kaum bekannt, welche Daten tatsächlich im Datensatz landen, und genau das erhöht das Risiko (Rn. 8).
Der Ablauf besteht nach der Leitlinie aus vier Schritten: Kriterien festlegen, Daten extrahieren, bereinigen sowie strukturieren und speichern (Rn. 11). Jeder dieser Schritte ist eine Verarbeitung personenbezogener Daten, sobald solche Daten im Material stecken. Enthält ein Datensatz Personenbezug und Sachdaten gemischt, gilt die DSGVO für den gesamten Bestand (Rn. 13).
Bei den Rollen gilt keine Pauschalregel. Wer scrapt, ist nicht automatisch Verantwortlicher. Wird im Auftrag eines anderen gearbeitet, kann eine Auftragsverarbeitung vorliegen. Legen mehrere Beteiligte Zwecke und Mittel gemeinsam fest, kommt eine gemeinsame Verantwortlichkeit in Betracht. Wer einen fertigen Datensatz kauft, verantwortet seine eigene Verarbeitung, auch wenn der Händler dieselben Daten zuvor erhoben hat (Rn. 16 bis 20). Für Unternehmen heißt das: Die Rolle ist im Einzelfall zu klären und zu dokumentieren, bevor ein Datensatz oder Scraping-Dienst eingesetzt wird.
Berechtigtes Interesse statt Einwilligung: der Dreistufentest für KI-Training
Eine Einwilligung scheidet bei der Massenerhebung aus Drittquellen praktisch aus, weil die Betroffenen nicht bekannt und nicht erreichbar sind (Rn. 44). Die Leitlinie hält andere Grundlagen für wenig passend und nennt das berechtigte Interesse nach Art. 6 Abs. 1 lit. f DSGVO als die in der Praxis häufig genutzte Grundlage (Rn. 43). Das ist kein Freifahrtschein, sondern ein Prüfauftrag. Wie sich die Vorschrift allgemein verhält, erklärt der Beitrag Das berechtigte Interesse im Datenschutz.
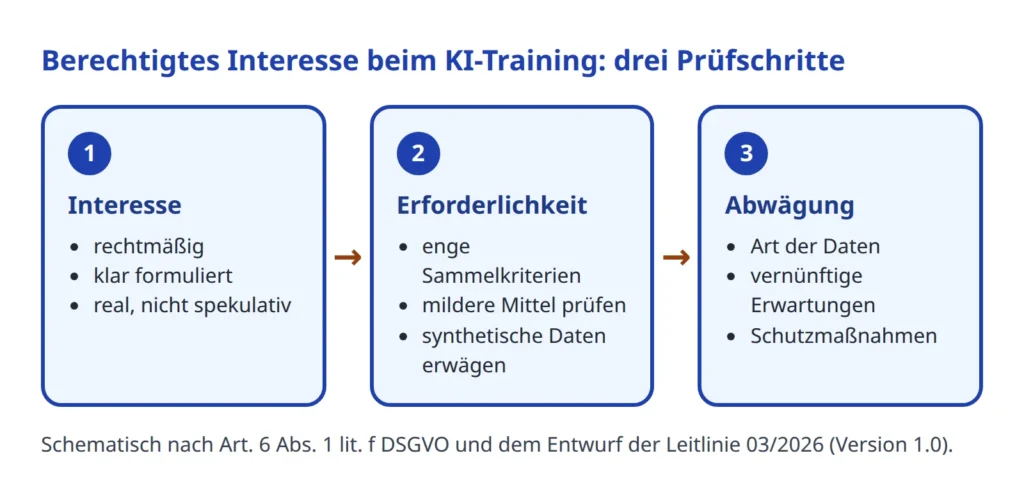
Die Prüfung läuft in drei Stufen (Rn. 47).
Erste Stufe, das Interesse: Es muss rechtmäßig, klar formuliert und real sein, also nicht bloß vermutet. Als Beispiele nennt die Leitlinie einen Konversationsagenten oder die Betrugserkennung (Rn. 48 bis 50). Ein vages „Irgendwann könnte ein Modell entstehen“ trägt nicht.
Zweite Stufe, die Erforderlichkeit: Zu fragen ist, ob sich das Ziel mit weniger Daten erreichen lässt. Enge Sammelkriterien sind besser als der Abgriff großer Teile des Netzes. Als milderes Mittel kommen pseudonymisierte oder synthetische Daten in Betracht (Rn. 51 und 52).
Dritte Stufe, die Abwägung: Hier stehen die Interessen der Betroffenen gegen das Interesse des Verantwortlichen. Die Leitlinie nennt als mögliche Folgen für Betroffene den Kontrollverlust über die eigenen Daten, ein Überwachungsgefühl, das Menschen vom Äußern abhalten kann („chilling effect“), und Missbrauch wie Deepfakes. Gewicht haben außerdem die Art der Daten, der Kontext der Veröffentlichung, die Folgen und die vernünftigen Erwartungen der Betroffenen (Rn. 53 bis 64).
Ein Punkt zieht sich durch die Abwägung: Aus einem trainierten Modell lassen sich einzelne Daten nach dem Stand der Technik kaum wieder entfernen (Rn. 60). Wer später löschen muss, kann das also oft nur durch erneutes Training erreichen. Deshalb sollen Fehler früh verhindert werden, nicht erst im Nachhinein. Ergänzend zählen Schutzmaßnahmen als Gewicht auf der Waage des Verantwortlichen (Rn. 65 und 66). Weshalb personenbezogene Daten in Modellen ein Problem sind, zeigt der Beitrag Personenbezogene Daten in KI-Modellen.
Die Leitlinie arbeitet mit Beispielen. In einem Fall werden Stimmaufnahmen ohne Zusatzmaßnahmen gesammelt. Das berechtigte Interesse trägt dort nicht (Beispiel 6). In einem anderen Fall entsteht ein Textmodell ausschließlich aus frei zugänglichen Quellen, die die Betroffenen offenkundig selbst öffentlich gemacht haben. Der Anbieter respektiert Text-und-Data-Mining-Vorbehalte, trifft Maßnahmen gegen das Auswendiglernen von Inhalten, erfüllt Betroffenenrechte und nennt seine Quellen öffentlich. Die Abwägung fällt dort in der Regel zugunsten des Verantwortlichen aus (Beispiel 7). Die Unterschiede liegen also nicht im Thema, sondern in den Schutzmaßnahmen.
Urheberrechtliche Schranken für Text und Data Mining ersetzen die Rechtsgrundlage nach der DSGVO nicht. Die Leitlinie erwähnt sie nur als Teil des Beispiels 7.
Öffentlich sichtbar heißt nicht frei verwendbar: Wer Webseiten für KI-Training ausliest, braucht auch bei frei zugänglichen Daten eine Rechtsgrundlage.
robots.txt, ai.txt und CAPTCHA: Was Betroffene vernünftigerweise erwarten
Im Rahmen der Abwägung kommt es darauf an, womit Betroffene rechnen müssen. Technische Signale spielen dabei eine Rolle. Die Leitlinie nennt Zugangsbeschränkungen, die robots.txt, die ai.txt und CAPTCHA. Solche Signale sprechen dagegen, dass Betroffene mit dem Auslesen durch Dritte rechnen (Rn. 37 und 64). Wer solche Signale ignoriert, verschlechtert damit seine Position in der Abwägung.
Zwei Missverständnisse liegen nahe. Das erste: Ein Verbot in der robots.txt wirke wie ein Gesetz. Die Leitlinie sagt das nicht. Das Signal verschiebt die Abwägung, ohne dass die robots.txt selbst rechtlich bindend wäre. Das zweite: Fehlt die robots.txt, sei das Auslesen erlaubt. Auch das stimmt nicht. Das Fehlen oder die Nichtanwendbarkeit einer robots.txt ist keine Einwilligung (Rn. 45). Es bedeutet nur, dass ein Gegengewicht fehlt.
Als Faustregel gilt: Hat eine Person Inhalte selbst für alle sichtbar öffentlich gemacht, ist die Erwartung einer Verarbeitung durch Dritte eher gegeben. Bei Beiträgen in Netzwerken mit Zugangsbeschränkung ist sie schwächer (Rn. 64). Die Beispiele 4 und 5 zeigen den Gegensatz. Eine Plattform ohne jedes Verbot steht einer Plattform gegenüber, die robots.txt und CAPTCHA einsetzt und das Scraping ausdrücklich untersagt. Im zweiten Fall ist das Auslesen deutlich schwerer zu rechtfertigen. Daten hinter einem Login und Registerabfragen mit vollständigen Namen, Adressen und Kontaktdaten gelten in der Leitlinie außerdem als Kandidaten für einen Ausschluss (Rn. 66 c).
Für Betreiber von Webseiten ergibt sich daraus ein praktischer Punkt. Wer das Auslesen durch KI-Crawler nicht wünscht, sollte die Signale bewusst setzen und prüfen, ob sie tatsächlich ausgeliefert werden. Ein Blick auf die eigene Seite hilft dabei, etwa mit dem DSGVO-Webseiten-Check, der unter anderem Datenabflüsse sichtbar macht.
Datenminimierung beim Web-Scraping: Prüfung vor dem ersten Abruf
Der Grundsatz der Datenminimierung verbietet das Training mit großen Datenmengen nicht. Er verlangt aber, personenbezogene Daten, die für den Zweck nicht erforderlich sind, gar nicht erst zu erheben (Rn. 36). Daraus folgt eine Reihenfolge, die man mit „erst prüfen, dann sammeln“ zusammenfassen kann.
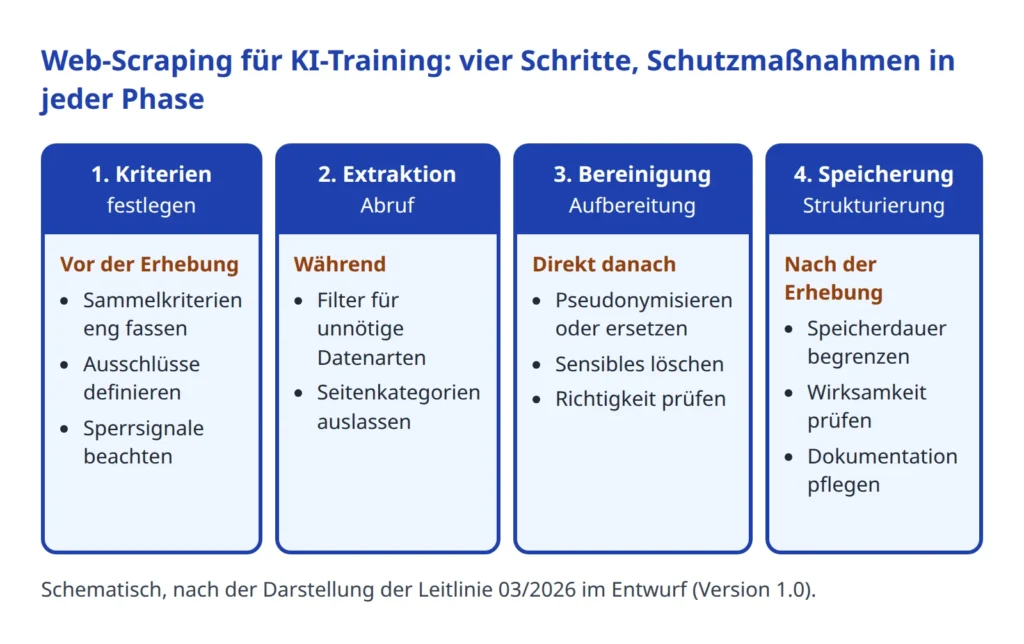
Vor der Erhebung soll zunächst geprüft werden, ob synthetische Daten genügen. Danach folgen präzise Sammelkriterien, ein Datenmapping mit Inventar und Filter für Datenarten, die nicht gebraucht werden, etwa Kontodaten oder Standortdaten. Außerdem sollen Webseitenkategorien ausgeschlossen werden, etwa Angebote, die überwiegend von Minderjährigen genutzt werden, und Seiten, die dem Scraping erkennbar widersprechen (Rn. 37).
Während und nach der Erhebung sieht die Leitlinie weitere Schritte vor. Syntaxbasierte Filter, zum Beispiel reguläre Ausdrücke für Telefon- oder Sozialversicherungsnummern, fangen typische Muster ab. Echte Daten lassen sich durch synthetische ersetzen, Datensätze können anonymisiert oder pseudonymisiert werden, und nicht benötigte Daten sind so früh wie möglich zu löschen (Rn. 38). Zur Richtigkeit zählen zuverlässige Quellen, Zeitstempel und eine Validierung der Daten vor dem Training (Rn. 39 bis 42).
| Phase | Maßnahme laut Leitlinie | Randnummer |
|---|---|---|
| Vor der Erhebung | Synthetische Daten erwägen, enge Sammelkriterien, Datenmapping, Filter, Ausschluss bestimmter Seitenkategorien und widersprechender Seiten | 37 |
| Während der Erhebung | Syntaxbasierte Filter, Ersetzen echter durch synthetische Daten | 38 |
| Nach der Erhebung | Anonymisieren oder Pseudonymisieren, frühes Löschen, Validierung vor dem Training | 38 bis 42 |
Der Kern liegt in der zeitlichen Verschiebung. Eine Bereinigung, die erst nach dem Abruf beginnt, kommt zu spät, weil die Daten dann bereits erhoben und gespeichert sind. Die Dokumentation der Kriterien und Ausschlüsse ist zugleich der wichtigste Nachweis in einer späteren Prüfung.
Datenminimierung beginnt vor dem ersten Abruf, nicht erst bei der Bereinigung des Datensatzes.
Transparenz beim Scraping: Wann Information entfallen darf und was dann zu veröffentlichen ist
Im Normalfall müssen Betroffene nach Art. 14 DSGVO informiert werden, wenn Daten nicht bei ihnen selbst erhoben werden. Eine Ausnahme besteht, wenn die Information unmöglich ist oder einen unverhältnismäßigen Aufwand erfordert (Art. 14 Abs. 5 lit. b). Die Leitlinie sagt klar, dass diese Ausnahme nicht routinemäßig genutzt werden darf, sondern vor allem bei Archiv-, Forschungs- und Statistikzwecken in Betracht kommt (Rn. 25 bis 27).
Die Abwägung erfolgt für den gesamten Datensatz. Berücksichtigt werden die Zahl der Betroffenen, das Alter der Daten und die ergriffenen Schutzmaßnahmen (Rn. 28). Wer sich auf die Ausnahme beruft, muss einen Ersatz liefern. Die Informationen sind öffentlich bereitzustellen, mit Datenkategorien, Zwecken, Rechtsgrundlage, Quellen und Merkmalen des Crawlers. Wenn möglich, gehört eine durchsuchbare Liste der Domains und URLs samt Erhebungszeitraum dazu, und auf nicht gelistete Quellentypen ist hinzuweisen (Rn. 30 und 31). Bei übernommenen Datensätzen ist der Kontakt des ursprünglichen Verantwortlichen zu nennen (Rn. 32). Als weitere Maßnahmen kommen die Veröffentlichung der Datenschutz-Folgenabschätzung, Pseudonymisierung, begrenzte Speicherdauer und Sicherheit in Betracht (Rn. 34).
Zwei Beispiele machen den Unterschied deutlich. Im ersten Fall geht es um ein sehr großes Archiv mit etwa 20 Jahre alten Forenbeiträgen, bei dem keine Kontaktmöglichkeit zu den Verfassern besteht. Die Ausnahme kann dort greifen, wenn die Ersatzmaßnahmen umgesetzt werden (Beispiel 2). Im zweiten Fall liegen Beiträge eines geschlossenen Nutzerkreises von 5.000 Personen vor, die über ihre E-Mail-Adressen direkt erreichbar sind. Dort ist individuell zu informieren (Beispiel 3). Je leichter sich Betroffene erreichen lassen, desto schwerer wiegt die Pflicht.
Zusammenhängend ist die Frage der Betroffenenrechte. Wer Auskunft, Berichtigung oder Löschung verlangt, muss identifizierbar sein. Ist ein Datensatz so aufgebaut, dass niemand zugeordnet werden kann, greifen diese Rechte nur eingeschränkt (Rn. 29). Das ist kein Schlupfloch, denn die Pflicht zur Transparenz bleibt davon unberührt. Welche Rolle Identifizierbarkeit spielt, behandelt der Beitrag Anonymisierung personenbezogener Daten.
Besondere Kategorien nach Art. 9: grundsätzlich verboten, auch beim Scraping
Daten zu Gesundheit, Religion, politischer Meinung, Sexualleben und weitere besondere Kategorien sind nach Art. 9 DSGVO grundsätzlich geschützt. Beim beabsichtigten Abgreifen solcher Daten braucht es neben einer Grundlage nach Art. 6 zusätzlich eine Ausnahme nach Art. 9 Abs. 2 (Rn. 67). Dass ein Datum öffentlich zugänglich ist, ersetzt diese Ausnahme nicht von selbst.
Das praktische Problem liegt woanders. Ob ein Datensatz sensible Daten enthält, zeigt sich oft erst nach dem Abgriff (Rn. 68). Ein Rest an Verarbeitung ist beim Scraping deshalb wahrscheinlich (Rn. 69). Für diesen Fall verweist die Leitlinie auf das EuGH-Urteil vom 24. September 2019 zu Suchmaschinen (C-136/17). Das Urteil kann für das zufällige und restliche Miterfassen relevant sein, ist aber keine allgemeine Ausnahme (Rn. 70 bis 72).
Vier Bedingungen müssen gemeinsam vorliegen (Rn. 73):
- Die Tätigkeit ähnelt der einer Suchmaschine.
- Die sensiblen Daten werden nur zufällig und restlich miterfasst.
- Die Bewertung vorab ist schwierig oder unmöglich.
- Der Verantwortliche trifft Maßnahmen im Rahmen seiner Verantwortung, Befugnisse und Fähigkeiten.
Die Maßnahmen sind konkret beschrieben (Rn. 74). Vor der Erhebung zählen Kriterien, Filter und der Ausschluss von Webseitenkategorien. Nach der Erhebung sind sensible Daten unverzüglich zu löschen, auch auf einen plausiblen Antrag eines Betroffenen. Bei der Modellentwicklung sollen Schutz gegen Extraktion, Ausgabefilter und Tests Abhilfe schaffen. Nach der Entwicklung gehören Monitoring der Ausgaben und langfristig auch Verfahren zum Verlernen („Unlearning“) dazu. Dazu kommen Nachweis und regelmäßige Wirksamkeitsprüfung (Rn. 75 bis 77).
Daraus folgen zwei Aussagen, die in Zusammenfassungen oft verkürzt werden. Erstens ist das gezielte, automatisierte Abgreifen sensibler Daten praktisch kaum zu rechtfertigen. Zweitens ist zufälliges Mitgreifen unter eng gefassten Bedingungen und mit Maßnahmen nicht automatisch rechtswidrig. Einen Freibrief gibt es nicht, ein pauschales Verbot aber ebenfalls nicht.
Anonymisierung nach Leitlinie 02/2026: Wann Trainingsdaten nicht mehr personenbezogen sind
Am selben Tag nahm der EDSA eine zweite Leitlinie an, die Guidelines 02/2026 on Anonymisation. Auch sie ist bis zum 30. Oktober 2026 in der Konsultation. Sie aktualisiert die Stellungnahme 05/2014 der Artikel-29-Datenschutzgruppe unter Berücksichtigung der neueren Rechtsprechung des EuGH, darunter das Urteil EDPS gegen SRB (C-413/23 P). Grundlage der folgenden Aussagen sind die Zusammenfassung und die ersten Randnummern der Leitlinie.
Der Kern: Daten sind anonym, wenn sie sich nicht auf eine identifizierte oder identifizierbare Person beziehen. Dabei kann es auf die Perspektive ankommen. Was für die eine Stelle anonym ist, kann für eine andere mit Zusatzwissen weiterhin personenbezogen sein. Als Prüfmaßstab nennt die Leitlinie drei Kriterien, nämlich keine Herausgreifbarkeit einzelner Datensätze („No Record Isolation“), keine Verknüpfbarkeit („No Linkage“) und keine Rückschlüsse auf Personen („No Inference“). Dafür gibt es einen kontextbezogenen und einen vereinfachten Weg.
Für das Scraping ist das in zweifacher Hinsicht relevant. Anonymisieren oder Pseudonymisieren ist eine Schutzmaßnahme, die die Scraping-Leitlinie ausdrücklich nennt. Ob ein Trainingsdatensatz oder ein fertiges Modell selbst als anonym gelten kann, behandelt die Scraping-Leitlinie nicht, und die Frage bleibt offen. Eine Vertiefung zur Identifizierbarkeit liefert der Beitrag Anonymisierung von Daten und Datenschutz.
Was Unternehmen jetzt prüfen sollten: Übersicht für eigenes Scraping und eingekaufte KI-Dienste
Die folgende Übersicht fasst die Maßstäbe der Leitlinie zusammen und nennt, was dafür dokumentiert werden sollte. Eine Prüfung im Einzelfall ersetzt die Übersicht nicht.
| Frage | Maßstab der Leitlinie | Zu dokumentieren |
|---|---|---|
| Rechtsgrundlage | Berechtigtes Interesse in drei Stufen (Rn. 43 bis 66) | Interesse, Erforderlichkeit, Abwägung schriftlich |
| Sammelkriterien und Ausschlüsse | Enge Kriterien, Ausschluss bestimmter Seiten (Rn. 37) | Kriterienliste, Ausschlussliste |
| Sperrsignale | robots.txt, ai.txt, CAPTCHA senken die Erwartung (Rn. 37, 45, 64) | Umgang mit Signalen, Protokoll des Crawlers |
| Filter und Löschung | Filter, Pseudonymisierung, frühes Löschen (Rn. 38) | Filterregeln, Löschfristen |
| Transparenz | Öffentliche Information, Liste der Quellen (Rn. 25 bis 34) | Transparenzseite, Begründung der Ausnahme |
| Besondere Kategorien | Ausnahme nach Art. 9 Abs. 2 oder strenge Maßnahmen (Rn. 67 bis 77) | Maßnahmenkatalog, Nachweise |
| Betroffenenrechte | Ausübung, soweit Identifizierung möglich (Rn. 29) | Verfahren für Anträge |
| Wirksamkeit | Regelmäßige Prüfung der Maßnahmen (Rn. 75 bis 77) | Prüfberichte, Testergebnisse |
Unternehmen, die selbst auslesen oder Scraper beauftragen, sollten zuerst die Rollen klären. Je nach Konstellation braucht es einen Vertrag zur Auftragsverarbeitung oder eine Vereinbarung zur gemeinsamen Verantwortlichkeit. Danach folgen die Abwägung, die Kriterien und die Dokumentation. Wer Datensätze von Händlern kauft, sollte sich Herkunft, Rechtsgrundlage und Quellenliste nennen lassen (Rn. 19 und 32).
Unternehmen, die KI nur einsetzen und nicht selbst trainieren, trifft die Leitlinie nur mittelbar. Bei der Auswahl eines Dienstes lohnen Fragen an den Anbieter nach Rechtsgrundlage, Quellen und Löschverfahren. Beim Training mit Nutzerdaten liegt der Fall anders, dazu zeigt der Beitrag KI-Training und die DSGVO mehr. Für die eigene Webseite gilt, dass die Sperrsignale bewusst gesetzt werden sollten, wenn ein Auslesen durch KI-Crawler nicht gewünscht ist. Wer die Sicherheit der eigenen Auftritte allgemein prüfen möchte, findet Ansatzpunkte bei den Web Security Checks.
Die zentrale Frage lässt sich damit knapp beantworten.
Darf alles ausgelesen werden, was öffentlich im Internet steht?
Wer zum Entwurf Stellung nehmen möchte, kann das bis zum 30. Oktober 2026 über das Formular des EDSA tun. Wann die endgültige Fassung erscheint, ist offen. Bis dahin liefert der Entwurf einen belastbaren Hinweis darauf, wie Aufsichtsbehörden das Auslesen öffentlicher Webseiten für KI beurteilen.