
 gekennzeichnet.
Kategorien: Datenschutz und Security
Wer eine Website angreifen will, beginnt mit Beobachten. Server-Header, Quelltext, Standardpfade und Zertifikate verraten oft in einer Minute, womit eine Seite arbeitet. Der Beitrag zeigt die Website aus Angreifersicht an der eigenen Seite, ordnet ein, was bloß Information und was ein echtes Risiko ist, und beschreibt eine Selbstprüfung mit Bordmitteln.
Die meisten Betreiber kennen ihre Website von innen: Das Backend, die Plugins, die Einstellungen. Von außen sieht die Seite anders aus. Dort gibt es keine Anmeldung und keine Rechte, nur das, was jeder Browser und jedes Skript abrufen kann. Genau diese Außensicht ist der Ausgangspunkt für automatisierte Scans und für gezielte Vorbereitung.
Der Beitrag geht die erste Minute dieser Außensicht in fünf Etappen durch. Er betrachtet ausschließlich öffentlich abrufbare Informationen und Prüfungen an der eigenen Website. Er enthält keine Anleitung zum Ausnutzen von Lücken und keine Aufforderung, fremde Systeme zu untersuchen. Aktive Scans fremder Systeme ohne Erlaubnis können strafbar sein und sind deshalb tabu. Der Text ist keine Rechtsberatung. Am Ende stehen eine Gewichtung der Funde, eine Selbstprüfung und eine Checkliste.
Die eigene Website aus Angreifersicht: Warum der Blick von außen zählt
Angriffe beginnen selten mit einem Angriff. Am Anfang steht die Aufklärung: Welche Software läuft, in welcher Version, welche Pfade gibt es, was liegt dort womöglich herum? Diese Phase nennt sich Informationsgewinnung. Das Open Worldwide Application Security Project (OWASP) führt sie in seinem Web Security Testing Guide als eigene Testphase auf, noch vor allen Prüfungen auf konkrete Schwachstellen. Die Website aus Angreifersicht zu betrachten heißt also: dieselben ersten Schritte nachzuvollziehen.
Dabei ist kein persönliches Interesse nötig. Ein großer Teil der Zugriffe auf jede öffentliche Seite stammt von automatisierten Programmen. Sie arbeiten Adresslisten ab, lesen Header und Quelltext und gleichen das Ergebnis mit bekannten Schwachstellen ab. Eine kleine Firmenseite steht in derselben Liste wie ein Konzernauftritt. Wer sich fragt, wer ausgerechnet die eigene Seite anschauen sollte, übersieht, dass hier niemand etwas anschaut. Es läuft ein Abgleich.
Wichtig ist die Unterscheidung zwischen Information und Schwachstelle. Eine Information ist etwa die Angabe, dass ein Webserver in einer bestimmten Version läuft. Eine Schwachstelle ist eine ausnutzbare Lücke. Die Information ist noch keine Lücke, sie hilft nur dabei, passende Lücken zu finden. Dieser Unterschied zieht sich durch den ganzen Beitrag. Informationspreisgabe ist ein Risikoverstärker, kein Einbruch.
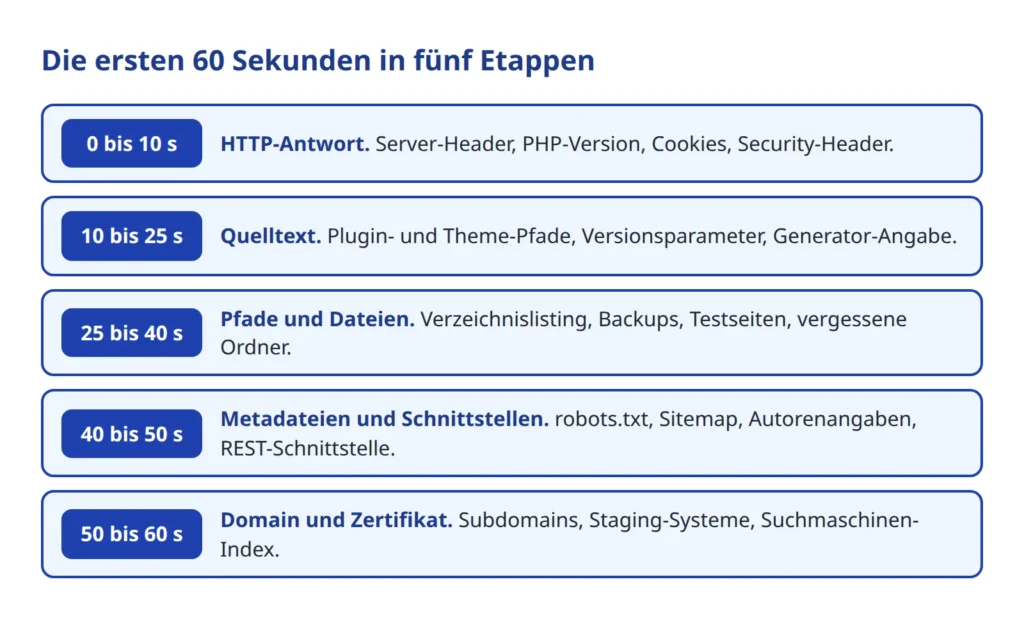
Die folgende Übersicht fasst die fünf Etappen zusammen, die in den nächsten Abschnitten einzeln behandelt werden. Die Zeitangaben sind ein Gedankenmodell. In der Praxis laufen die Schritte automatisiert und parallel, sie dauern eher Sekundenbruchteile.
Sekunde 0 bis 10: Was die HTTP-Antwort verrät
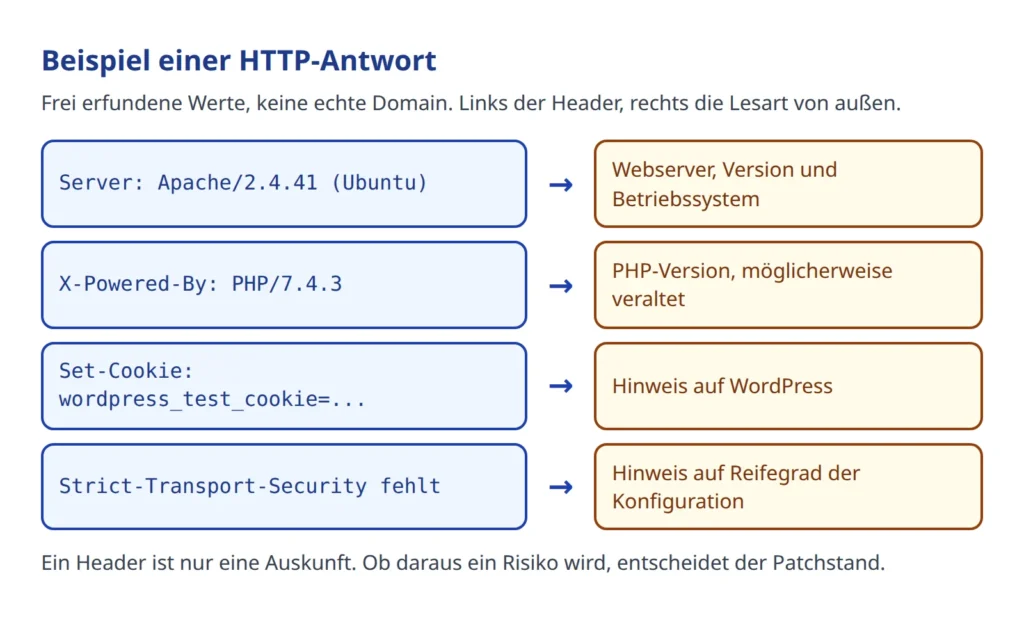
Schon der erste Abruf der Startseite liefert neben dem Inhalt eine Reihe von Kopfzeilen, die Header. Sie sind für den Browser gedacht, aber jeder kann sie lesen. Typisch ist der Server-Header. Er nennt häufig den Webserver, dessen Version und manchmal das Betriebssystem. Dazu kommt oft X-Powered-By mit der PHP-Version. Auch Cookie-Namen verraten viel: Ein Cookie mit dem Präfix wordpress_ macht das eingesetzte System sofort erkennbar.
Das Auslesen dieser Angaben heißt Banner Grabbing. Der OWASP-Leitfaden zum Fingerprinting von Webservern (WSTG-INFO-02) beschreibt den Zweck so: Typ und Version des Servers bestimmen, um zu prüfen, ob bekannte Schwachstellen für diese Version vorliegen. Veraltete Server ohne aktuelle Korrekturen sind dafür besonders anfällig. Zugleich weist der Leitfaden darauf hin, dass sich solche Header ändern oder verschleiern lassen.
Auch fehlende Angaben sagen etwas aus. Wer die Header für den Transportschutz (HSTS) oder für eine Inhaltsrichtlinie (CSP) nicht setzt, zeigt, dass an der Konfiguration lange nichts getan wurde. Das ist kein Beweis für eine Lücke, aber ein Hinweis auf den Reifegrad. Weiterleitungen von HTTP auf HTTPS, Fehlerseiten und die Reihenfolge der Header sind weitere Spuren.
Soll die Version nicht mehr im Header stehen, lässt sich das bei Apache einstellen. Laut Apache-Dokumentation steuert die Direktive ServerTokens, wie viel der Server-Header preisgibt. Standardwert ist Full mit Version, Betriebssystem und Modulen. Mit ServerTokens Prod bleibt nur Server: Apache übrig. Die Direktive ServerSignature regelt die Fußzeile auf vom Server erzeugten Seiten, etwa Fehlerseiten. Ihr Standardwert ist Off. Bei nginx übernimmt server_tokens off eine ähnliche Aufgabe. Bei PHP lässt sich expose_php abschalten, damit X-Powered-By entfällt. Wer die Server-Version verbergen will, findet die Einstellung also in der Regel in einer einzigen Zeile der Konfiguration.
Ehrlich bleibt das nur mit einem Zusatz: Das Verbergen ist keine Sicherheit, sondern bestenfalls Verzögerung. Verhalten und Fehlerseiten eines Servers lassen sich weiterhin einordnen, wie auch der OWASP-Leitfaden festhält. Wichtiger als ein versteckter Header ist ein Server, der ohnehin aktuell ist.
Sekunde 10 bis 25: Quelltext, Plugin-Liste und Theme-Hinweise
Der Quelltext einer Seite ist öffentlich. Bei WordPress stehen darin die Adressen aller eingebundenen Skripte und Stylesheets. Diese Adressen enthalten die Pfade wp-content/plugins und wp-content/themes samt Ordnernamen. Daraus ergibt sich ohne jede Anmeldung eine Liste der aktiven Plugins und des Themes. Oft hängt am Ende der Adresse ein Versionsparameter wie ?ver=. Auch das Generator-Meta-Tag nennt gelegentlich die WordPress-Version. Wer wissen will, wie leicht sich eine WordPress-Plugin-Version auslesen lässt, muss nur den eigenen Quelltext durchsuchen.
Ergänzend können Dateien im Plugin-Ordner selbst Versionen nennen, zum Beispiel eine mitgelieferte readme.txt. Dazu kommen Kommentare im Quelltext, Pfade aus der Entwicklungsumgebung und Hinweise auf Werkzeuge, mit denen die Seite gebaut wurde. Nichts davon ist für sich gefährlich. Zusammen ergibt es aber ein ziemlich genaues Bild der technischen Grundlage.
Der nächste Schritt ist ein Abgleich mit öffentlichen Schwachstellendatenbanken. Dort sind bekannte Lücken nach Produkt und Version aufgelistet, und zwar ausdrücklich, damit Betreiber ihre Seiten schützen können. Automatisierte Programme nutzen dieselben Daten. Ein Plugin, das seit Monaten kein Update erhalten hat und in der Liste auftaucht, ist damit auffindbar, ohne dass jemand die Seite je besucht hätte.
Eine Versionsnummer im Header ist noch keine Schwachstelle. Sie macht nur sichtbar, ob eine bekannte Lücke offen sein könnte.
Der Quelltext verrät noch etwas anderes: Welche Drittdienste eingebunden sind. Tracking-Skripte, eingebettete Videos, externe Schriften und Karten tauchen als Adressen auf fremden Servern auf. Für die Sicherheit ist das nebensächlich. Für den Datenschutz ist es ein Nebenbefund, denn jeder dieser Dienste erhält die IP-Adresse der Besucher. Ein Blick auf die Liste lohnt deshalb doppelt.
Eine Konsequenz ist deutlich: Plugins und Themes, die nicht gebraucht werden, gehören entfernt und nicht nur deaktiviert. Das Hardening-Kapitel der WordPress-Entwicklerdokumentation empfiehlt ebenfalls, Software aktuell zu halten und Unbenutztes zu löschen. Was nicht installiert ist, kann nicht veralten.
Sekunde 25 bis 40: Offene Verzeichnisse, Standardpfade und vergessene Dateien
Nach dem Quelltext folgen Pfade, die sich ohne Verlinkung erraten lassen. Bei WordPress sind das etwa /wp-admin, /wp-login.php und /wp-json. Diese Pfade sind überall gleich und überall dokumentiert. Dass sie existieren, ist normal und kein Befund. Interessant wird es, wenn sich dahinter mehr zeigt als vorgesehen.
Das erste Beispiel ist das Verzeichnislisting. Fehlt in einem Ordner eine Startdatei und ist die Auflistung erlaubt, erzeugt der Server eine Dateiliste. Die Apache-Dokumentation beschreibt das so: Wird eine Adresse angefragt, die auf ein Verzeichnis zeigt, und liegt dort kein DirectoryIndex wie index.html, liefert mod_autoindex eine formatierte Auflistung. Bei offenen Verzeichnissen kann jeder sehen, welche Dateien dort liegen, etwa im Upload-Ordner. Das Verzeichnislisting lässt sich per Apache-Direktive Options -Indexes deaktivieren, bei nginx genügt es, autoindex nicht zu aktivieren.
Das zweite Beispiel sind vergessene Dateien. Beim Umbau oder Umzug einer Website bleiben gern Dinge liegen: ein Datenbank-Export, ein Archiv mit der alten Seite, eine Sicherungskopie der Konfiguration, ein Ordner der Versionsverwaltung, eine Datei mit Zugangsdaten, eine Testseite mit Systeminformationen. Die Dateiendungen und Namen sind so üblich, dass Skripte sie als Liste abfragen. Wer eine solche Datei auf dem eigenen Server nicht kennt, sollte sie finden, bevor es jemand anders tut.
Warum das mehr als ein Schönheitsfehler ist, liegt auf der Hand. Datenbank-Exporte enthalten Kundendaten, Konfigurationsdateien Zugangsdaten. Wer solche Dateien frei abrufbar lässt, macht aus einem Verwaltungsfehler eine Datenpanne. Die DSGVO verlangt in Artikel 32 technische und organisatorische Maßnahmen, die dem Risiko angemessen sind. Offen herumliegende Exporte widersprechen dem, ohne dass es dafür eine Angriffsleistung brauchte. Weiterführend zum Personenbezug solcher Datensätze behandelt der Beitrag zu personenbeziehbaren Daten die Frage, wann Daten als personenbezogen gelten.
Die Gegenmaßnahmen sind unspektakulär. Sicherungen und Exporte gehören außerhalb des öffentlich erreichbaren Verzeichnisses (Webroot) oder zumindest hinter eine Zugriffssperre. Die Dateirechte sollten nicht großzügiger sein als nötig. Die WordPress-Dokumentation nennt für Verzeichnisse 755 und für Dateien 644, für wp-config.php 400 oder 440. Debug-Ausgaben gehören im Livebetrieb abgeschaltet, ebenso Testskripte mit Systemangaben.
Sekunde 40 bis 50: Metadateien, Nutzernamen und Schnittstellen
Metadateien sind für Suchmaschinen und Programme gedacht. Die bekannteste ist die robots.txt. Sie sagt Crawlern, was sie nicht abrufen sollen. Genau darin liegt ein Missverständnis. Der OWASP-Leitfaden zu Metadateien (WSTG-INFO-03) stellt klar, dass die robots.txt nicht als Mechanismus zur Durchsetzung von Beschränkungen gelten sollte. Wer dort einen internen Pfad ausschließt, nennt ihn zugleich jedem, der die Datei liest. Ein Pfad gehört also nicht in die robots.txt, wenn er geheim bleiben soll, sondern hinter eine Anmeldung. Ähnlich verhält es sich mit der Sitemap: Sie ist eine bewusste Liste der Seiten und sollte nichts enthalten, was nicht öffentlich sein soll.
Dann die Benutzernamen. Gültige Benutzernamen sind für Angriffe auf Anmeldungen nützlich, denn dann fehlt nur noch das Passwort. Mehrere Quellen kommen infrage: Autoren-Archive, die den Anmeldenamen in der Adresse tragen, Fehlermeldungen beim Login, die zwischen falschem Namen und falschem Passwort unterscheiden, und die REST-Schnittstelle. Laut REST-Referenz zu Nutzern liefert die Abfrage von Nutzern im Kontext view Felder wie Anzeigename, Kurzname (slug), Link und Beschreibung. Felder wie E-Mail-Adresse und Rollen sind dem Kontext edit vorbehalten. Ob und welche Nutzer unangemeldet erscheinen, steht dort nicht eindeutig. Das Verhalten hängt von der WordPress-Version und der Konfiguration ab und lässt sich am schnellsten an der eigenen Seite prüfen: Ruft der Browser die Nutzer-Schnittstelle unter /wp-json/wp/v2/users der eigenen Domain ab, zeigt sich, was ohne Anmeldung ausgegeben wird. Der Kurzname entspricht nicht automatisch dem Anmeldenamen, kann ihm aber ähneln.
Als sinnvolle Gegenmaßnahmen kommen einheitliche Fehlermeldungen beim Login, sparsam vergebene Autorenkonten, Anzeigenamen, die vom Anmeldenamen abweichen, und starke Passwörter mit einem zweiten Faktor infrage. Ein verborgener Benutzername ist ebenfalls nur eine Hürde. Die eigentliche Absicherung ist, dass ein bekannter Name allein nichts nützt.
Die security.txt ist das Gegenbeispiel: eine Metadatei, die ausdrücklich gefunden werden soll. RFC 9116 beschreibt sie als Datei unter /.well-known/security.txt mit den Pflichtfeldern Contact und Expires. Wer eine Schwachstelle findet, erfährt dort, wohin die Meldung gehen soll. Das ist die kontrollierte Variante von Sichtbarkeit.
Sekunde 50 bis 60: Domain, Zertifikat und Suchmaschinen
Die letzte Etappe verlässt die Seite selbst. Zertifikate für HTTPS werden in öffentlichen Protokollen vermerkt, der sogenannten Zertifikatstransparenz. Das Verfahren ist in RFC 6962 beschrieben, die Nachfolgeversion trägt die Nummer 9162. Der Zweck ist, falsch ausgestellte Zertifikate sichtbar zu machen. Als Nebenwirkung steht in diesen Protokollen jeder Hostname, für den ein Zertifikat ausgestellt wurde. Wer für test, staging oder intranet unter der eigenen Domain ein Zertifikat beantragt, trägt diesen Namen damit öffentlich ein.
Hinzu kommen die DNS-Einträge der Domain. Sie zeigen Mailserver, Subdomains und Dienste. Und schließlich der Suchmaschinen-Index: Eine Suche mit site: und der eigenen Domain listet auf, was Suchmaschinen kennen. Dazu können PDF-Dateien, Testseiten, Exportdateien und alte Seitenversionen gehören, die nie jemand finden sollte.
Besonders anfällig sind Staging-Systeme. Das sind Kopien der Seite zum Testen. Sie laufen oft mit älterer Software, schwächeren Passwörtern oder abgeschalteter Absicherung, enthalten aber nicht selten echte Daten. Wird ein Staging-System nicht mit einem Passwortschutz versehen, kann es in Suchmaschinen landen. Für diese Etappe gilt wie für alle anderen: Es werden nur öffentlich zugängliche Quellen genutzt, und nur für die eigene Domain. Das Durchsuchen fremder Systeme ist keine Prüfung, sondern ein Eingriff.
Was aus den Funden folgt: Information, Risiko, Aufwand
Nach den fünf Etappen stellt sich die Frage der Gewichtung. Nicht jede sichtbare Angabe verlangt sofortiges Handeln. Eine Seite ohne sichtbare Spuren gibt es nicht. Die Frage lautet, was ein Fund für sich bedeutet, und was erst in Kombination gefährlich wird. Die Tabelle ordnet die häufigsten Funde ein.
| Fund | Was ein Angreifer daraus macht | Gegenmaßnahme | Dringlichkeit |
|---|---|---|---|
| Server- und PHP-Version im Header | Abgleich mit bekannten Lücken dieser Version | Updates einspielen, Version im Header ausblenden | Mittel |
| Plugin-Liste mit Versionen im Quelltext | Suche nach veralteten Plugins mit bekannten Lücken | Aktualisieren, Unbenutztes entfernen | Hoch bei veralteten Plugins |
| Offenes Verzeichnislisting | Dateiliste durchsehen, interessante Dateien abrufen | Auflistung abschalten, Inhalte prüfen | Mittel bis hoch |
| Backup oder Datenbank-Export abrufbar | Zugangsdaten und personenbezogene Daten auslesen | Entfernen, außerhalb des Webroots speichern, Zugangsdaten ändern | Sehr hoch, sofort |
| Benutzernamen sichtbar | Gezielte Anmeldeversuche | Starke Passwörter, zweiter Faktor, einheitliche Fehlermeldungen | Mittel |
| Staging-System erreichbar | Schwächer geschützte Kopie der Seite angreifen | Passwortschutz, Abschalten, Index prüfen | Hoch |
| robots.txt mit internen Pfaden | Pfade als Wegweiser nutzen | Pfade nicht aufführen, hinter Anmeldung legen | Niedrig |
Wer Versionsnummern versteckt, gewinnt Zeit. Wer aktualisiert, gewinnt Sicherheit.
Dieser Satz fasst die wichtigste Erkenntnis zusammen. Das Verbergen der Version ist ein Handgriff von wenigen Minuten und senkt das Rauschen, es ersetzt aber keine Aktualisierung. Fingerprinting erkennt Server häufig auch ohne Banner. Wer sich auf das Verstecken verlässt, praktiziert Security through Obscurity, also Sicherheit durch Geheimhaltung der Technik. Die Verfahren bleiben sinnvoll als zusätzliche Schicht, nicht als Ersatz.
Nach Aufwand sortiert ergibt sich eine einfache Reihenfolge. Zuerst kommen die Dinge, die schnell gehen und viel bringen: Updates für Kern, Plugins und Themes, ungenutzte Erweiterungen entfernen, offene Backups und Exporte wegnehmen. Danach folgen Verzeichnislisting abschalten, Dateirechte prüfen, Debug-Ausgaben ausschalten und Staging-Systeme absichern. Zum Schluss kommen die Feinarbeiten: Header minimieren, Sicherheits-Header ergänzen und eine security.txt bereitstellen. Wer so vorgeht, verkleinert die Angriffsfläche der Website dort am stärksten, wo es zählt.
Die zentrale Frage dieses Beitrags lässt sich nach den fünf Etappen so beantworten:
Was sieht ein Angreifer von außen auf einer Website, ohne sich anzumelden?
Selbstprüfung der eigenen Website: Schritt für Schritt mit Bordmitteln
Für die erste Bestandsaufnahme genügt ein Browser. Wichtig ist der Rahmen: Geprüft wird ausschließlich die eigene Website, oder eine, für die eine ausdrückliche Erlaubnis vorliegt. Fremde Seiten sind tabu, auch aus Neugier.
Der erste Schritt sind die Header. In den Entwicklerwerkzeugen des Browsers zeigt der Reiter Netzwerk beim Laden der Seite die Antwort-Header des ersten Abrufs. Wer die Kommandozeile bevorzugt, bekommt dasselbe mit curl -I https://domain.example/, wobei die Beispieladresse durch die eigene Domain zu ersetzen ist. Notiert werden Server, X-Powered-By, Cookies und vorhandene Sicherheits-Header.
Der zweite Schritt ist der Quelltext. Die Ansicht des Seitenquelltexts lässt sich mit der Suche nach wp-content, ?ver=, generator und nach Kommentaren durchgehen. Das ergibt die Plugin- und Theme-Liste, wie sie auch von außen zu sehen ist. Danach folgt der Abgleich mit dem Backend: Gibt es dort Erweiterungen, die nicht mehr gebraucht werden?
Der dritte Schritt betrifft Verzeichnisse. WordPress-Ratgeber empfehlen, Ordner wie /wp-content/uploads/ oder /wp-includes/ der eigenen Seite im Browser aufzurufen. Erscheint eine Dateiliste statt einer Fehlermeldung oder leeren Seite, ist das Verzeichnislisting aktiv. Der vierte Schritt sucht von Hand nach Dateien, die nicht öffentlich sein sollen: Exporte, Archive, Konfigurationskopien, Testseiten. Am zuverlässigsten gelingt das nicht über Raten von außen, sondern über einen Blick ins Dateisystem des eigenen Servers. Was dort im öffentlichen Ordner liegt, ist auch von außen erreichbar.
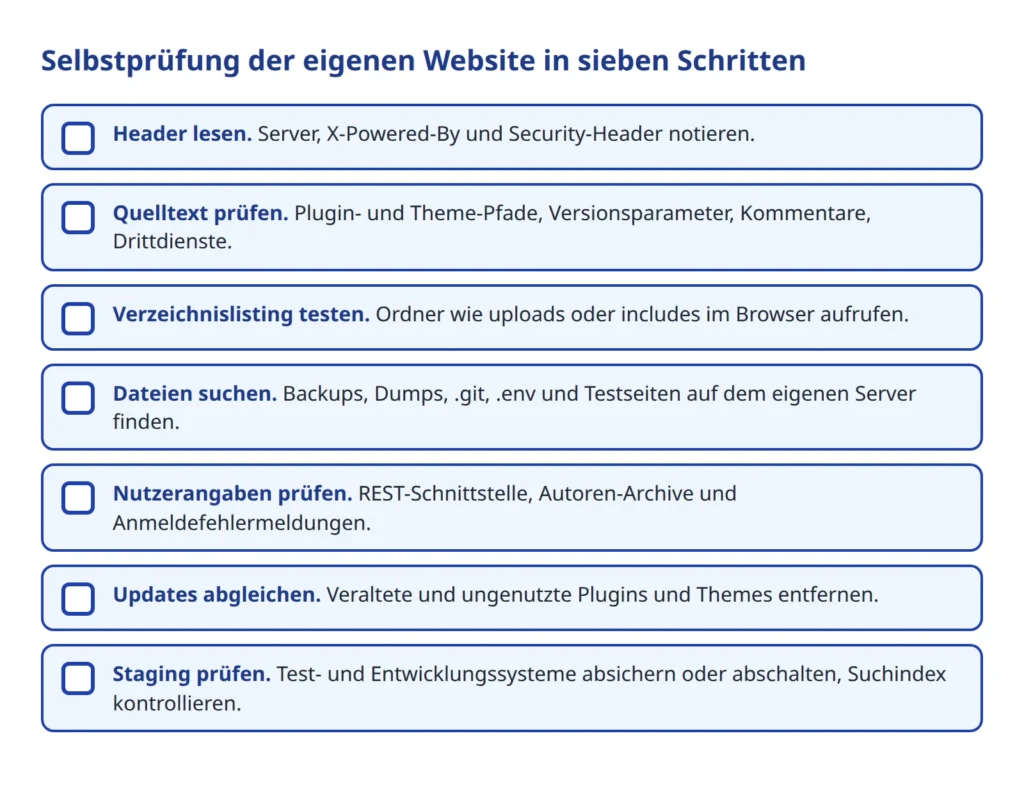
Der fünfte Schritt gilt den Nutzerangaben. Der Aufruf der REST-Nutzerliste, die Adresse eines Autoren-Archivs und eine absichtlich falsche Anmeldung zeigen, was die Seite preisgibt. Im sechsten Schritt wird mit site: und der eigenen Domain bei einer Suchmaschine geprüft, was im Index steht. Der siebte Schritt betrifft Staging- und Testsysteme: Sind sie erreichbar, geschützt und aus dem Index ferngehalten? Die Abbildung fasst die Schritte als Checkliste zusammen.
Manuelle Prüfung hat Grenzen. Sie ist langsam und hängt davon ab, dass die richtigen Stellen angesehen werden. Ergänzend kommen automatisierte Auswertungen infrage. Der Webseiten-Check von Dr. DSGVO betrachtet eine Seite aus datenschutzrechtlicher Sicht, etwa Drittdienste und Cookies. Für technische Aspekte wie Header, Versionsangaben und Standardpfade sind die Security-Checks von wwwschutz.de eine mögliche Ergänzung. Beides ersetzt kein Gespräch mit dem Hoster oder der Agentur, hilft aber dabei, das Bild zu vervollständigen. Und wer beim Netzwerk-Panel ohnehin sitzt, kann dort zugleich nachsehen, welche Anfragen die Seite beim Laden auslöst, wie es der Beitrag zu Speculation Rules und Datenschutz für das Vorab-Laden zeigt.
Fazit: Sichtbarkeit begrenzen, Aktualität sichern
Die erste Minute der Außensicht zeigt vor allem eines: Eine Website verrät mehr, als ihre Betreiber ahnen. Das ist normal und lässt sich nicht vollständig verhindern. Es lässt sich aber begrenzen und, wichtiger, entschärfen.
- Informationen sind keine Schwachstellen, werden aber zu Wegweisern, wenn die Software veraltet ist.
- Aktualisierte Software ist wirksamer als jede Verschleierung. Ungenutzte Plugins und Themes werden gelöscht, nicht nur deaktiviert.
- Offene Verzeichnisse, vergessene Exporte und erreichbare Staging-Systeme sind die Funde mit dem größten Schaden und gehören zuerst behoben.
- Die Versionsangabe im Header zu verbergen ist eine sinnvolle Zusatzschicht, aber kein Ersatz für Updates.
- Bewusst Veröffentlichtes wie die
security.txthilft, Meldungen in die richtige Richtung zu lenken.
Eine regelmäßige Selbstprüfung, etwa nach größeren Änderungen an der Seite, kostet wenig Zeit. Der Beitrag ist keine Rechtsberatung und keine Aufforderung, fremde Systeme zu scannen. Wo Unsicherheit besteht, hilft die Rücksprache mit dem Hoster, der Agentur oder einer fachkundigen Stelle.