
 gekennzeichnet.
Kategorien: Datenschutz
Die meisten Menschen lassen Einstellungen, wie sie sind. Bei Chatbots kann das bedeuten, dass eigene Eingaben zum Training dienen. Es wird beschrieben, warum der Standard so mächtig ist, was das Recht dazu sagt und was die Trägheit der Menschen (und der Menschheit) über den Datenschutz verrät.
Einleitung
Ein neues Konto ist schnell angelegt. Ein Dialog erscheint, ein Häkchen ist schon gesetzt, ein großer Knopf sagt „Weiter“. Wenige Sekunden später ist der Dienst nutzbar, und niemand hat gelesen, was dabei festgelegt wurde. Dieser Alltagsmoment wiederholt sich bei Browsern, Apps, Smartphones und inzwischen bei Chatbots.
Es wird beschrieben, wie solche Voreinstellungen entstehen und warum sie in der Praxis oft die eigentliche Entscheidung sind. Dazu gehören ein Blick in die Verhaltensforschung, die rechtliche Einordnung, konkrete Beispiele aus dem Bereich der KI-Chatbots und die Grenzen der Schalter, die Anbieter bereitstellen. Am Ende stehen praktische Schritte für Privatpersonen und Organisationen.
Voreinstellungen im Datenschutz: Warum der Standard die eigentliche Entscheidung ist
Eine Voreinstellung ist der Wert, der gilt, solange niemand etwas ändert. Das kann ein Häkchen sein, ein Schalter in den Einstellungen oder ein Vertragstext, dem mit der Anmeldung zugestimmt wird. Der Hersteller legt diesen Wert fest, lange bevor die erste Person den Dienst öffnet.
Bei den Voreinstellungen im Datenschutz geht es darum, welche Daten ein Dienst sammelt, wie lange er sie speichert und wer sie sehen darf. Ein paar alltägliche Beispiele zeigen die Bandbreite:
- Ein Browser schlägt eine Startseite und eine Suchmaschine vor, die Daten über das Surfverhalten erhält.
- Eine App fragt beim ersten Start nach dem Standort, und die Auswahl „Immer erlauben“ ist farbig hervorgehoben.
- Ein soziales Netzwerk macht Beiträge zunächst für alle sichtbar.
- Ein Chatbot nutzt Gespräche zur Verbesserung seines Modells, solange das nicht ausgeschaltet wird.
In allen Fällen gibt es formal eine Wahl. In der Praxis bleibt aber die Mehrheit beim Vorgegebenen. Der Standard wird dadurch zur tatsächlichen Regel für die allermeisten Konten. Wer ihn setzt, entscheidet also nicht für sich selbst, sondern für sehr viele andere.
Das ist der Kern der These: Datenschutz hängt im Alltag weniger vom Recht auf dem Papier ab als von der Frage, welcher Wert beim ersten Start eingestellt ist. Ein Recht, das nur mit aktivem Handeln genutzt werden kann, erreicht zwangsläufig nur einen Teil der Betroffenen.
Der Default-Effekt: Was Organspende-Daten über Zustimmung verraten
Die Verhaltensforschung nennt dieses Phänomen den Default-Effekt, verwandt mit der Status-quo-Verzerrung. Menschen wählen überproportional häufig die Option, die schon ausgewählt ist. Das gilt für Sparpläne, Stromtarife, Software und Datenschutzoptionen gleichermaßen.
Das bekannteste Beispiel stammt aus der Organspende. Die Forscher Eric Johnson und Daniel Goldstein verglichen 2003 in der Fachzeitschrift Science die Spenderquoten europäischer Länder. Ihr Befund: In Ländern, in denen Zustimmung ausdrücklich erklärt werden muss, liegt der Anteil der erfassten Spender deutlich unter dem Anteil in Ländern, in denen Widerspruch nötig ist. Die Studie ist unter dem Titel Do Defaults Save Lives? erschienen. Genaue Prozentwerte werden hier bewusst nicht genannt, denn sie hängen von der Berechnung ab. Wichtig ist die Richtung des Unterschieds.
Der Standard wirkt besonders dort, wo die Entscheidung schwerfällt, wenig bekannt ist oder als lästig gilt. Genau das trifft auf viele Datenschutzfragen zu.
Mehrere Gründe tragen dazu bei, dass Voreinstellungen so stark wirken:
- Aufwand: Eine Einstellung zu finden, kostet Zeit. Der Nutzen ist abstrakt, die Kosten sind sofort spürbar.
- Stille Empfehlung: Ein vorgegebener Wert wirkt, als habe jemand mit Sachverstand ihn für gut befunden.
- Überforderung: Die Folgen einer Datenverarbeitung sind schwer einzuschätzen. Wer die Risiken nicht überblickt, entscheidet sich für das Naheliegende.
- Trägheit: Was einmal läuft, wird selten überprüft.
Auch der Verbraucherzentrale Bundesverband hat diese Mechanik für soziale Netzwerke beschrieben. Das Hintergrundpapier zu Voreinstellungen von 2011 hält fest, dass die Wahl der Voreinstellung großen Einfluss darauf hat, wie viele Nutzer ihre Daten preisgeben. Der Befund ist über ein Jahrzehnt alt, die Mechanik gilt heute für KI-Dienste genauso.
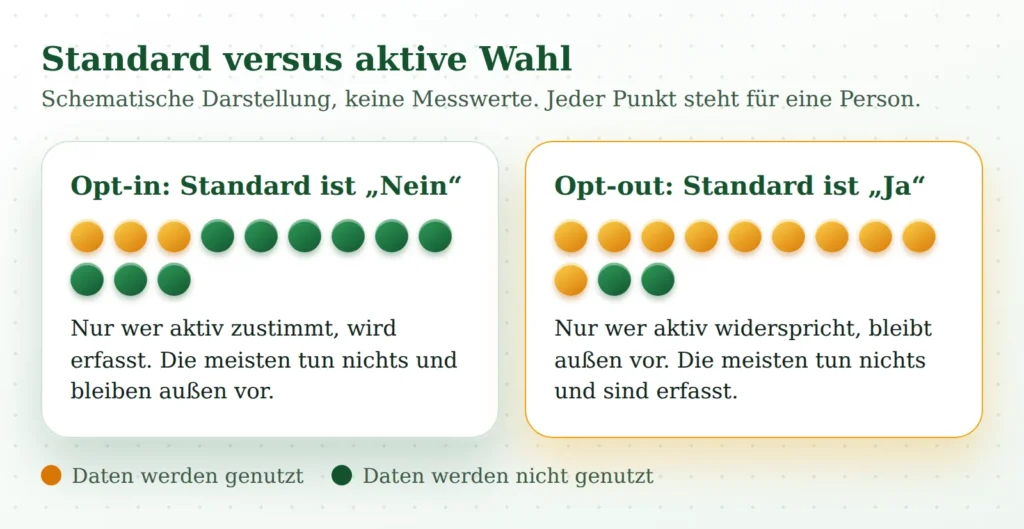
Die Abbildung zeigt das Prinzip schematisch. Es sind keine Messwerte, sondern ein Denkmodell: Dieselbe Gruppe Menschen landet je nach Standard in ganz unterschiedlichen Ergebnissen, obwohl sich an ihrem Verhalten nichts ändert.
Standardeinstellungen im Datenschutz: Was Art. 25 DSGVO verlangt und wo die Grenze liegt
Das Recht kennt das Problem. Mit Artikel 25 der DSGVO ist „Datenschutz durch datenschutzfreundliche Voreinstellungen“ (Privacy by Default) eine Pflicht des Verantwortlichen. Gemeint ist: Ohne Zutun der Nutzer darf standardmäßig nur die Verarbeitung stattfinden, die für den jeweiligen Zweck erforderlich ist. Das betrifft die Menge der erhobenen Daten, den Umfang der Verarbeitung, die Speicherfrist und die Zugänglichkeit.
Ein Beispiel verdeutlicht den Gedanken. Persönliche Angaben dürfen durch Voreinstellungen nicht ohne Eingreifen der Person einer unbestimmten Zahl von Menschen zugänglich gemacht werden. Ein Profil, das zunächst für alle im Netz sichtbar ist, wäre damit schwer vereinbar.
Die Europäische Kommission erläutert diese Pflicht auf ihren Seiten für Unternehmen und Organisationen. Der Europäische Datenschutzausschuss hat in seinen Leitlinien 4/2019 zu Datenschutz durch Technikgestaltung und durch Voreinstellungen beschrieben, wie die Vorgabe auszulegen ist. Diese Leitlinien sind eine Auslegungshilfe und kein Gesetzestext.
Wichtig ist die Reichweite der Regel. Artikel 25 verlangt, dass die Voreinstellung auf das Erforderliche beschränkt ist. Er beantwortet aber nicht, ob eine bestimmte Datennutzung überhaupt zulässig ist. Dafür braucht jede Verarbeitung eine eigene Rechtsgrundlage, etwa eine Einwilligung oder ein berechtigtes Interesse. Stützt sich ein Anbieter auf ein berechtigtes Interesse, gibt es keine Einwilligung, die aktiv erteilt werden müsste. Dann bleibt häufig nur ein Widerspruch, und genau dieser Weg liegt beim KI-Training im Mittelpunkt der Debatte.
Die Pflicht zu datenschutzfreundlichen Voreinstellungen schützt also vor allem dort, wo Daten über das Nötige hinaus verarbeitet werden. Ob das Training eines Sprachmodells zum Erforderlichen gehört, ist eine eigene Frage, die der Anbieter für sich beantwortet und die Aufsichtsbehörden und Gerichte prüfen können.
Chatbot-Eingaben und Training: Wo der Standard gegen die Nutzer arbeitet
Chatbots sind ein anschauliches Beispiel, weil Eingaben oft sehr persönlich sind. Es werden Entwürfe für Briefe, Fragen zu Krankheiten, Konflikte am Arbeitsplatz oder Auszüge aus Verträgen eingegeben. Genau solche Inhalte sind für die Verbesserung von Modellen wertvoll. Ob sie dafür verwendet werden, entscheidet je nach Anbieter und Tarif eine Voreinstellung.
OpenAI
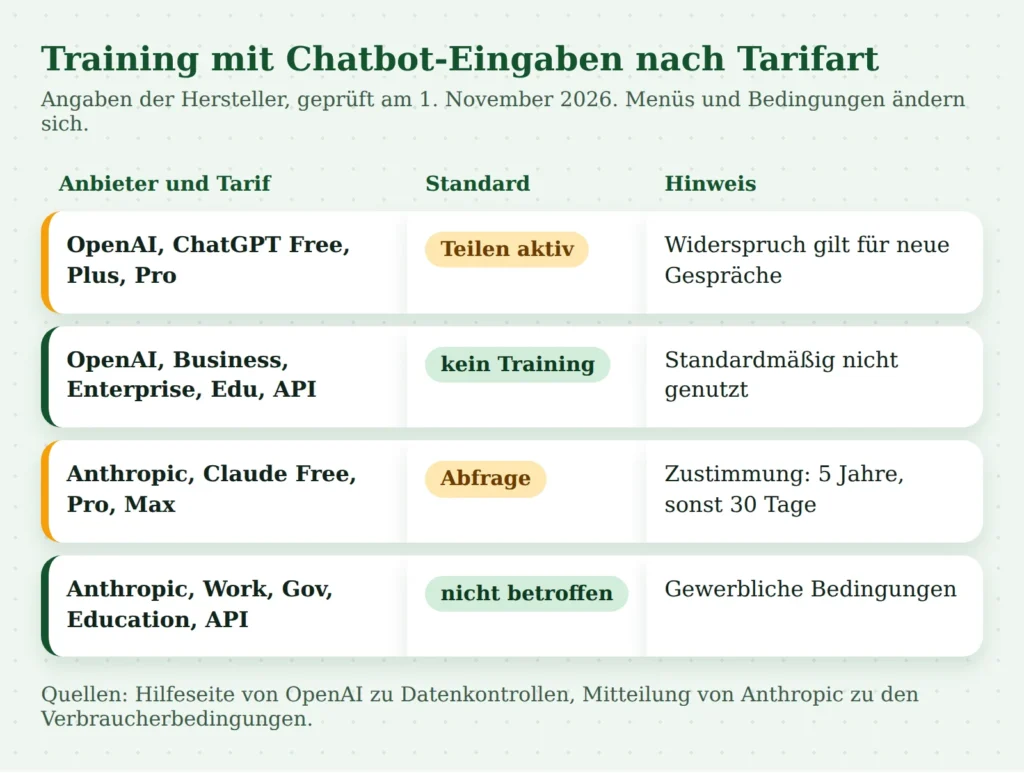
Nach der Hilfeseite von OpenAI zu den Datenkontrollen ist bei persönlichen ChatGPT-Konten (Free, Plus, Pro) die Option „Das Modell für alle verbessern“ standardmäßig aktiviert. Wer das nicht möchte, muss sie in den Datenkontrollen ausschalten. Bei Business-, Enterprise-, Edu- und Healthcare-Workspaces werden Inhalte dagegen standardmäßig nicht zum Training verwendet, ebenso wenig Ein- und Ausgaben über die Programmierschnittstelle.
Das ist ein klarer Fall: Wer privat nichts tut, bei dem gilt der Standard. Wer im Unternehmenstarif arbeitet, dessen Inhalte werden nach Herstellerangaben standardmäßig nicht zum Training genutzt.
Anthropic
Anthropic hat am 28. August 2025 die Verbraucherbedingungen für Claude Free, Pro und Max geändert. Seitdem können Nutzer wählen, ob ihre Daten zur Verbesserung von Claude verwendet werden. Bei Zustimmung gilt eine Aufbewahrung von fünf Jahren, ohne Zustimmung bleibt es bei 30 Tagen. Bestehende Nutzer hatten bis zum 8. Oktober 2025 Zeit, ihre Auswahl zu treffen. Nicht betroffen sind Dienste unter gewerblichen Bedingungen wie Claude for Work, Claude Gov, Claude for Education und die API.
Hier nennt die Primärquelle keine vorausgewählte Option, sondern beschreibt eine Abfrage. Ob und wie das Auswahlfeld im jeweiligen Dialog voreingestellt war, lässt sich der Mitteilung nicht entnehmen. Für die Wirkung des Standards ist das dennoch lehrreich: Auch eine Abfrage kann so gestaltet sein, dass eine Antwort bequemer erscheint als die andere.
Andere Anbieter
Zu weiteren Diensten wie Meta AI, Microsoft Copilot, Mistral oder Google Gemini kursieren viele Anleitungen, die sich teils widersprechen. Hier werden bewusst keine Standardwerte genannt, weil sie sich je nach Konto, Land und Version ändern und die Herstellerseiten jeweils selbst zu prüfen sind. Die Übersicht oben zeigt deshalb nur Angaben, die an Herstellerquellen belegt sind. Sie trägt das Prüfdatum, denn Bedingungen und Menüs ändern sich häufig.
Warum bleiben fast alle bei der Standardeinstellung, auch wenn Chatbots Eingaben für das Training nutzen?
Opt-out statt Opt-in: Warum Anbieter diesen Weg wählen und was ein Gericht dazu sagte
Für Anbieter ist die Rechnung einfach. Eine Einwilligung (Opt-in) müsste aktiv eingeholt werden, und die meisten dürften sie nach dem Default-Effekt nicht erteilen. Bei einer Widerspruchslösung (Opt-out) stehen dagegen von Anfang an fast alle Daten zur Verfügung. Der Unterschied entspricht dem Bild aus der Abbildung oben. Dass ein Anbieter den zweiten Weg wählt, ist wirtschaftlich nachvollziehbar, aus Sicht des Datenschutzes aber der Punkt, an dem der Standard gegen die Betroffenen arbeitet.
Wie weit das rechtlich trägt, zeigte ein Verfahren um das KI-Training von Meta. Die Verbraucherzentrale NRW wollte per Eilantrag erreichen, dass Meta öffentliche Beiträge aus Facebook und Instagram nur mit aktiver Zustimmung für das KI-Training nutzt. Das Oberlandesgericht Köln wies den Antrag mit Beschluss vom 23. Mai 2025 (Az. 15 UKl 2/25) zurück. Die Verbraucherzentrale beschreibt das in einer Mitteilung zum Beschluss.
Nach dieser Darstellung sah das Gericht im Eilverfahren die Widerspruchslösung als zulässig an. Meta dürfe sich auf ein berechtigtes Interesse stützen, das Training der eigenen KI sei ein solches Interesse. Ausschlaggebend war unter anderem, dass Nutzer nach der Ankündigung im Juni 2024 damit rechnen konnten, dass öffentliche Inhalte für KI genutzt werden, und dass Meta Informationen und Möglichkeiten zum Widerspruch bereitstellte.
Es ist wichtig, diese Entscheidung richtig einzuordnen. Sie erging in einem Eilverfahren mit summarischer Prüfung. Eine Entscheidung in der Hauptsache ist das nicht, und sie betrifft die konkreten öffentlichen Beiträge bei Meta, nicht automatisch jeden Chatbot. Für die Frage dieses Beitrags bleibt aber eine Erkenntnis: Wo ein berechtigtes Interesse als Rechtsgrundlage anerkannt wird, liegt die Last beim Widerspruch. Wer nicht widerspricht, bleibt im Standard.
Der Aufwand verschiebt sich damit vom Anbieter zur Person. Nicht der Dienst muss begründen, warum Daten genutzt werden dürfen, sondern die Person muss rechtzeitig und aktiv die Nutzung beenden.
Was das Opt-out nicht leistet: Grenzen der Schalter
Selbst wer den Schalter findet und ausschaltet, erreicht weniger, als oft angenommen wird. Die Hilfeseite von OpenAI nennt dazu einige Punkte, die auch für andere Dienste als Prüfliste taugen.
- Wirkung nur für die Zukunft: Der Widerspruch gilt für neue Gespräche. Gespeicherte Chats werden dadurch weder gelöscht noch ausgeblendet. Was früher eingegeben wurde und was bereits in ein Modell eingeflossen ist, wird damit nicht zurückgeholt.
- Feedback-Daumen: Wer eine Antwort mit Daumen hoch oder runter bewertet, macht das zugehörige Gespräch nach der Hilfeseite unter Umständen trotz Widerspruch für das Training verfügbar.
- Temporäre Chats: Sie werden nicht zum Training verwendet, erscheinen nicht im Verlauf und erzeugen keine Erinnerungen. Aus Sicherheitsgründen können sie aber bis zu 30 Tage aufbewahrt werden.
- Speicherung ist nicht Training: Auch ohne Training werden Gespräche gespeichert. Der Schalter regelt, wofür Daten verwendet werden, nicht, ob sie anfallen.
- Je Dienst eine Einstellung: Wer mehrere Werkzeuge nutzt, muss jedes einzeln prüfen, auch Zusatzfunktionen mit eigenen Einstellungen.
Hinzu kommt der Faktor Zeit. Anbieter ändern Bedingungen, Menüs und Voreinstellungen. Eine Einstellung, die vor einem Jahr geprüft wurde, kann heute anders aussehen. Aus der einmaligen Entscheidung wird eine dauerhafte Aufgabe.
Was die Trägheit über Datenschutz verrät
Dass fast alle beim Standard bleiben, ist kein Zeichen von Gleichgültigkeit. Es ist die vorhersehbare Reaktion auf eine Lage, in der Entscheidungen zu zahlreich, zu technisch und zu unscheinbar sind. Ein einzelner Mensch müsste Dutzende Dienste prüfen, Bedingungen lesen und Einstellungen regelmäßig kontrollieren. Das leistet im Alltag praktisch niemand.
Wer nichts tut, hat trotzdem entschieden: für den Standard, den ein anderer gesetzt hat.
Daraus folgt eine unbequeme Einsicht. Das Modell der individuellen Selbstbestimmung, das Einwilligung und Widerspruch voraussetzen, verlangt von jedem Einzelnen sehr viel. Es funktioniert gut bei wenigen, wichtigen Entscheidungen. Bei hunderten kleinen Schaltern, die laufend neu gesetzt werden, überfordert es.
Deshalb ist die Gestaltung wichtiger, als es zunächst wirkt. Ein datenschutzfreundlicher Standard schützt auch jene, die sich nie mit den Einstellungen beschäftigen. Ein datenhungriger Standard nutzt genau diese Gruppe aus. Der Unterschied liegt nicht im Recht, das für alle gleich ist, sondern in einer Voreinstellung, die an einem einzigen Ort im Unternehmen festgelegt wird.
Für Anbieter folgt daraus eine Verantwortung. Wer Voreinstellungen setzt, setzt Verhaltensregeln für Millionen. Für Aufsicht und Verbraucherschutz folgt daraus, dass der Blick auf die Voreinstellungen mindestens so wichtig ist wie der Blick auf die Datenschutzerklärung. Für Einzelne bleibt, dass die wichtigsten Schalter gezielt geprüft werden sollten, statt alles zu prüfen.
Voreinstellungen prüfen und ändern: Praktische Schritte für Privatpersonen und Organisationen
Es muss nicht jede Einstellung kontrolliert werden. Ein kurzer Durchgang bei den Diensten, in die persönliche oder betriebliche Inhalte fließen, bringt den größten Nutzen.
Für Privatpersonen
- In den Konto- und Datenschutzeinstellungen des Chatbots nach der Trainingsoption suchen und bewusst entscheiden.
- Für sensible Themen temporäre Chats nutzen, dabei aber die Aufbewahrung von bis zu 30 Tagen beachten.
- Gesundheitsdaten, Zugangsdaten und Angaben zu anderen Personen gar nicht erst eingeben.
- Bewertungen per Daumen sparsam einsetzen, wenn ein Gespräch nicht ins Training gelangen soll.
- Den Haken in Abständen neu prüfen, weil Anbieter Bedingungen ändern.
Für Organisationen
- Keine Kunden-, Beschäftigten- oder Vertragsdaten in private Konten eingeben. Dienstlich gehören Business-Tarife oder Schnittstellen mit vertraglicher Regelung zur Datenverarbeitung hin, bei denen das Training nach den Herstellerangaben nicht der Standard ist.
- Verbindlich festlegen, welche Chatbots mit welchen Daten genutzt werden dürfen, und diese Regel den Beschäftigten bekannt machen.
- Voreinstellungen der eigenen Systeme prüfen, nicht nur die der Zulieferer.
Auch bei der eigenen Website zählen Voreinstellungen. Lädt ein Tracking-Dienst oder eine Einbindung bereits vor der Einwilligung, entscheidet ebenfalls ein Standard über den Datenabfluss. Ein DSGVO Website Check zeigt, welche Dienste beim ersten Seitenaufruf aktiv werden. Wer die technischen Standardwerte von Servern und Webanwendungen kontrollieren will, findet bei den Web Security Checks einen passenden Einstieg.
Fazit
Voreinstellungen sind die stille Machtstruktur des Datenschutzes. Sie entscheiden für die Mehrheit, weil Aufwand, Überforderung und die Wirkung des Vorgegebenen zusammenkommen. Bei Chatbots mit privaten Konten kann daraus eine faktische Zustimmung zum Training mit eigenen Eingaben werden, während Business-Tarife häufig anders voreingestellt sind.
Das Recht verlangt datenschutzfreundliche Voreinstellungen, klärt aber nicht jede Datennutzung. Ein Opt-out wirkt nur für die Zukunft und hat Lücken. Wirksamer Datenschutz entsteht deshalb dort, wo der Standard schützt, und nicht erst dort, wo einzelne Personen ihn mühsam verändern.